PerplexityとNVIDIAは2026年8月25日、手元のパソコン上でAIエージェントを動かす「Portable Computer」の提供を開始しました。各紙の見出しは「トークン課金ゼロ」ですが、NVIDIAの公式表現は「トークン上限にカウントされない」であり、AI利用料が消えるという話ではありません。消えるのはトークン課金という変動費で、代わりにハードウェアという固定費が乗ります。本記事では、経営とDXの現場が持っている数字だけで、この置き換えが自社に得か損かを判断する軸を整理します。
2026年8月25日に何が発表されたのか
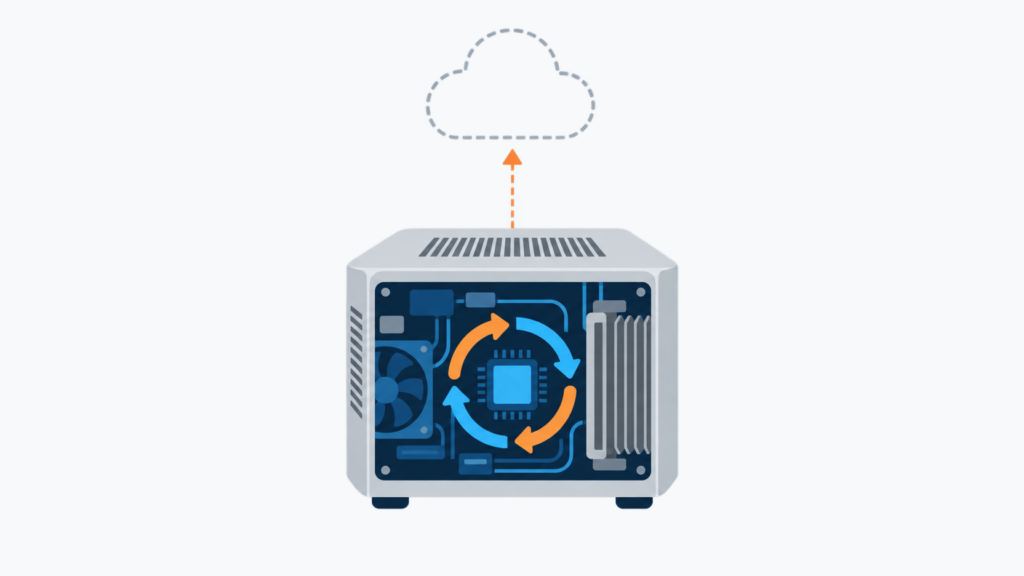
PerplexityとNVIDIAは2026年8月25日、AIエージェント「Portable Computer」を提供開始しました。クラウドを経由せず、モデル・ファイル・処理のすべてを手元のマシン上に置いて動かす構成が特徴です。
NVIDIAは公式ブログで、Portable Computerを「トークン上限にカウントされない、ローカルの非公開ワークフロー」を実現するものと説明しています。提供開始時点の要件と内容は次のとおりです。
| 項目 | 内容(2026年8月時点) |
|---|---|
| 提供開始日 | 2026年8月25日 |
| 提供元 | Perplexity(NVIDIAと協業) |
| 中心となるハードウェア | NVIDIA DGX Spark |
| そのほかの対応環境 | NVIDIA RTX GPU(VRAM 24GB以上)搭載のLinux PC |
| Windows対応 | 2026年9月予定 |
| Apple Silicon対応 | ロードマップ外 |
| ローカルで動くモデル | Qwen 3.8 27B/PPLX 27B(Perplexityが自社ハーネス上で追加学習) |
| 今後対応するモデル | NVIDIA Nemotron 3.5 Lightning |
| 外部サービス連携 | Google Drive、Gmail、Slack、GitHub |
対応の中心となるNVIDIA DGX Sparkは、NVIDIA GB10 Grace Blackwell スーパーチップを搭載したデスクトップ機です。20コアのArm CPU、128GBのコヒーレント統合メモリ、273GB/sのメモリ帯域、最大1 PFLOP(FP4)の演算性能、4TBの自己暗号化NVMeストレージという構成で、270億〜300億パラメータ級のモデルを1台で動かすことを想定しています。
今後対応予定のNVIDIA Nemotron 3.5 Lightningは、300億パラメータのMoE(mixture-of-experts:入力ごとに一部の専門ネットワークだけを使う方式)モデルです。NVIDIAは同等のオープンモデルと比べて最大4倍のトークン生成速度、30%短い完了時間としています。常時稼働のエージェント向けに設計されたモデルという位置づけです。
「トークン課金なし」が意味すること、意味しないこと
Portable Computerで消えるのは、クラウドAPIに処理を投げるたびに積み上がる従量課金です。Perplexityの契約プラン自体が不要になるわけではありません。
ここが誤読されやすい点です。VentureBeatとTechSpotはいずれも、Portable Computerの提供対象をPerplexityのPro・Max・Enterprise契約者としています。つまりPortable Computerは、月額サブスクリプションを置き換えるものではなく、プランに含まれるクレジットを超えて発生する分を抑える仕組みと読むのが実態に近いと考えられます。
なお、この契約プラン要件はPerplexityの公式発表で確認できていません。
3種類のコストの出方を整理すると、置き換えの正体が見えます。
| コストの種類 | クラウド利用のみ | Portable Computer(ローカル実行) |
|---|---|---|
| 月額サブスクリプション | 必要 | 必要(報道ベース・一次未確認) |
| トークン/クレジットの従量課金 | 使うほど増える | ローカル処理分は上限にカウントされない |
| ハードウェア投資 | 不要 | 必要(DGX SparkまたはRTX 24GB以上のPC) |
| 電力・運用の手間 | 提供元が負担 | 自社が負担 |
つまり構造としては、変動費(トークン課金)を固定費(ハードウェア投資)に置き換える選択肢です。固定費化は使用量が多いほど有利になり、少なければ割高になります。AI利用料が右肩上がりで読めないという悩みには効きますが、そもそも従量課金が発生していない企業には効きません。
固定費化が効く条件・効かない条件
ローカル実行AIへの投資が回収できるかは、「毎月いくら従量課金を払っているか」と「その処理をローカルモデルで代替できるか」の2点で決まります。
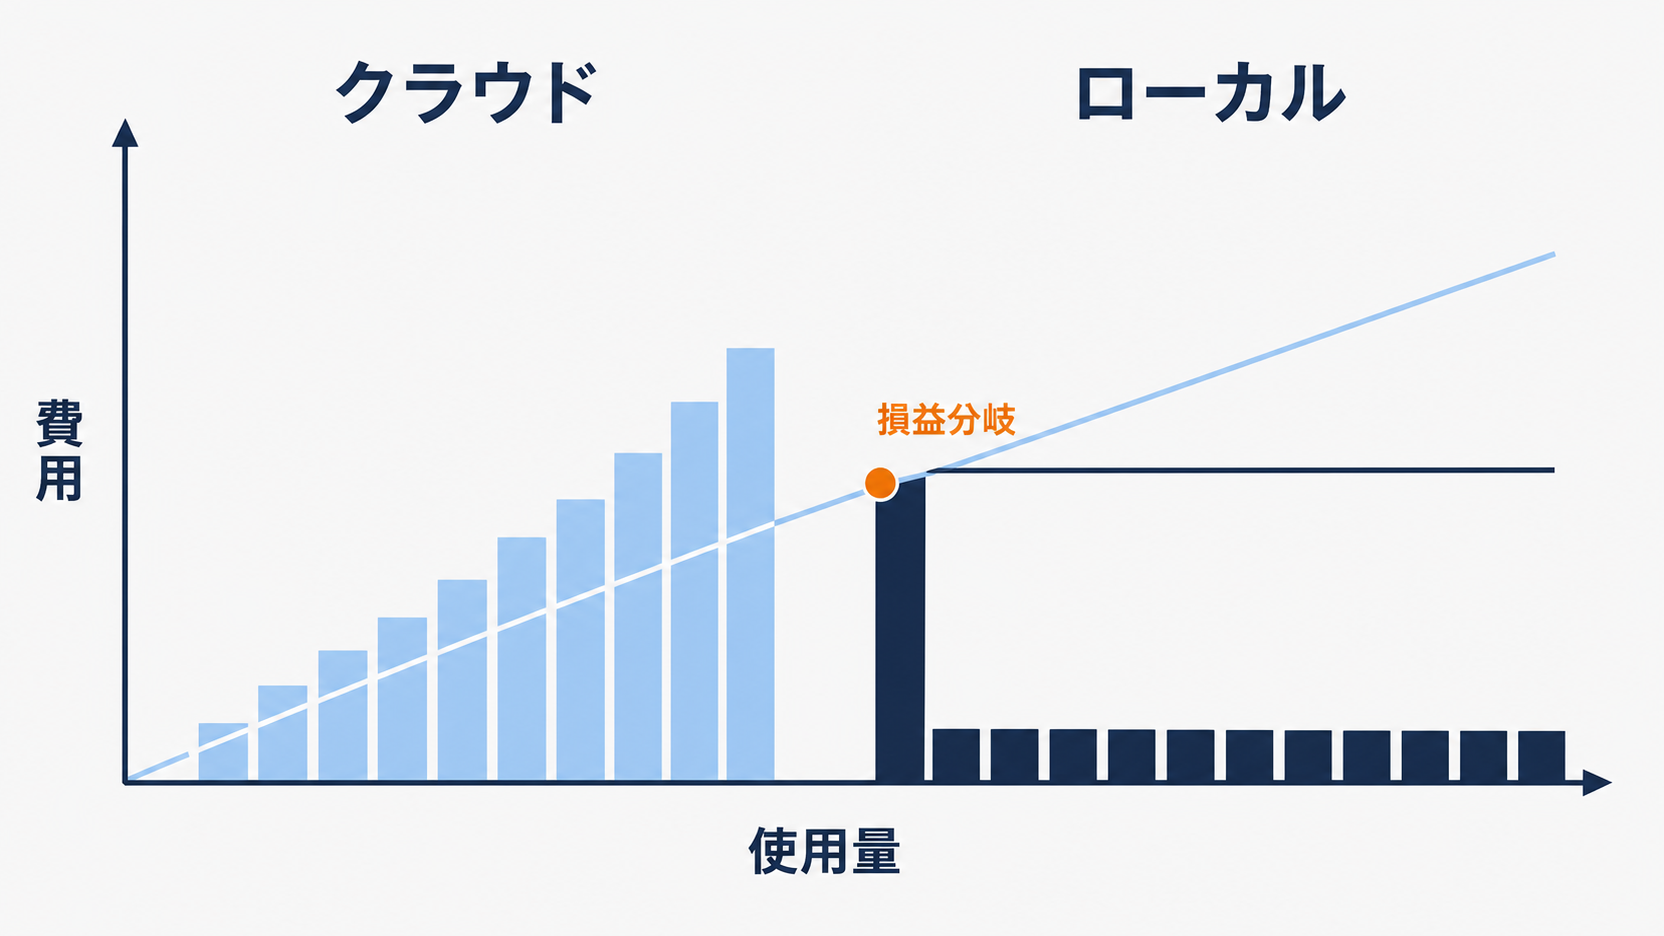
判断は、次の算式に自社の数字を入れるだけで足ります。
回収月数 = ハードウェア導入費 ÷(ローカルに移せる月あたりの従量課金額 − 追加の電力・運用費)
この形にすると、効く条件と効かない条件がはっきり分かれます。
固定費化が効く条件
- プランのクレジット上限を毎月超えており、超過分が継続的に発生している
- 長時間かかる調査・要約・データ処理を、夜間や休日を含めて常時流したい(DGX Sparkは24時間稼働を前提に設計されている)
- 同じ処理を繰り返す定型業務が多く、270億〜300億パラメータ級のモデルでも品質が足りる
固定費化が効かない条件
- 従量課金がほとんど発生しておらず、プラン内で収まっている
- 使う頻度が月に数回で、投資した機材が遊ぶ
- 最上位モデルの推論品質が必要で、結局クラウドへ委譲する処理が大半になる
3つ目は特に注意が必要です。Portable Computerは複雑なタスクをクラウドの上位モデルへ委譲できる「ハイブリッド」動作を備えています。委譲の頻度が高いままなら、従量課金は減らずハードウェア費だけが増えます。導入前に、自社の処理のうち何割がローカルモデルで完結するかを実測する必要があります。
AI利用の従量課金がどう膨らむかという構造については、AI推論コストが2028年に5倍になるという予測とエージェント導入の費用設計も併せてご覧ください。単価の下落と使用量の増加が同時に起きるため、単価だけを見ていると請求額を読み誤ります。
機密管理で本当に効くのは「同意ゲート」
ローカル実行の価値は「データが端末から出ない」ことではなく、「データが出る瞬間を人が決められる」ことにあります。ハイブリッド動作では、承認すればデータはクラウドへ送られます。
VentureBeatの報道によれば、Portable Computerはクラウドの上位モデルを呼ぶ前に、送信予定の文脈をPII分類器(個人情報を検出する仕組み)に通し、端末から出る内容を画面に表示してユーザーの同意を求めます。リモートモデルが返すのはテキストの助言のみで、ローカルのファイルやツールには直接触れません。SiliconANGLEは、サンドボックスによってOSへの不正アクセスと想定外の外部通信が遮断され、SaaS連携から端末上のファイルが保護されると報じています。
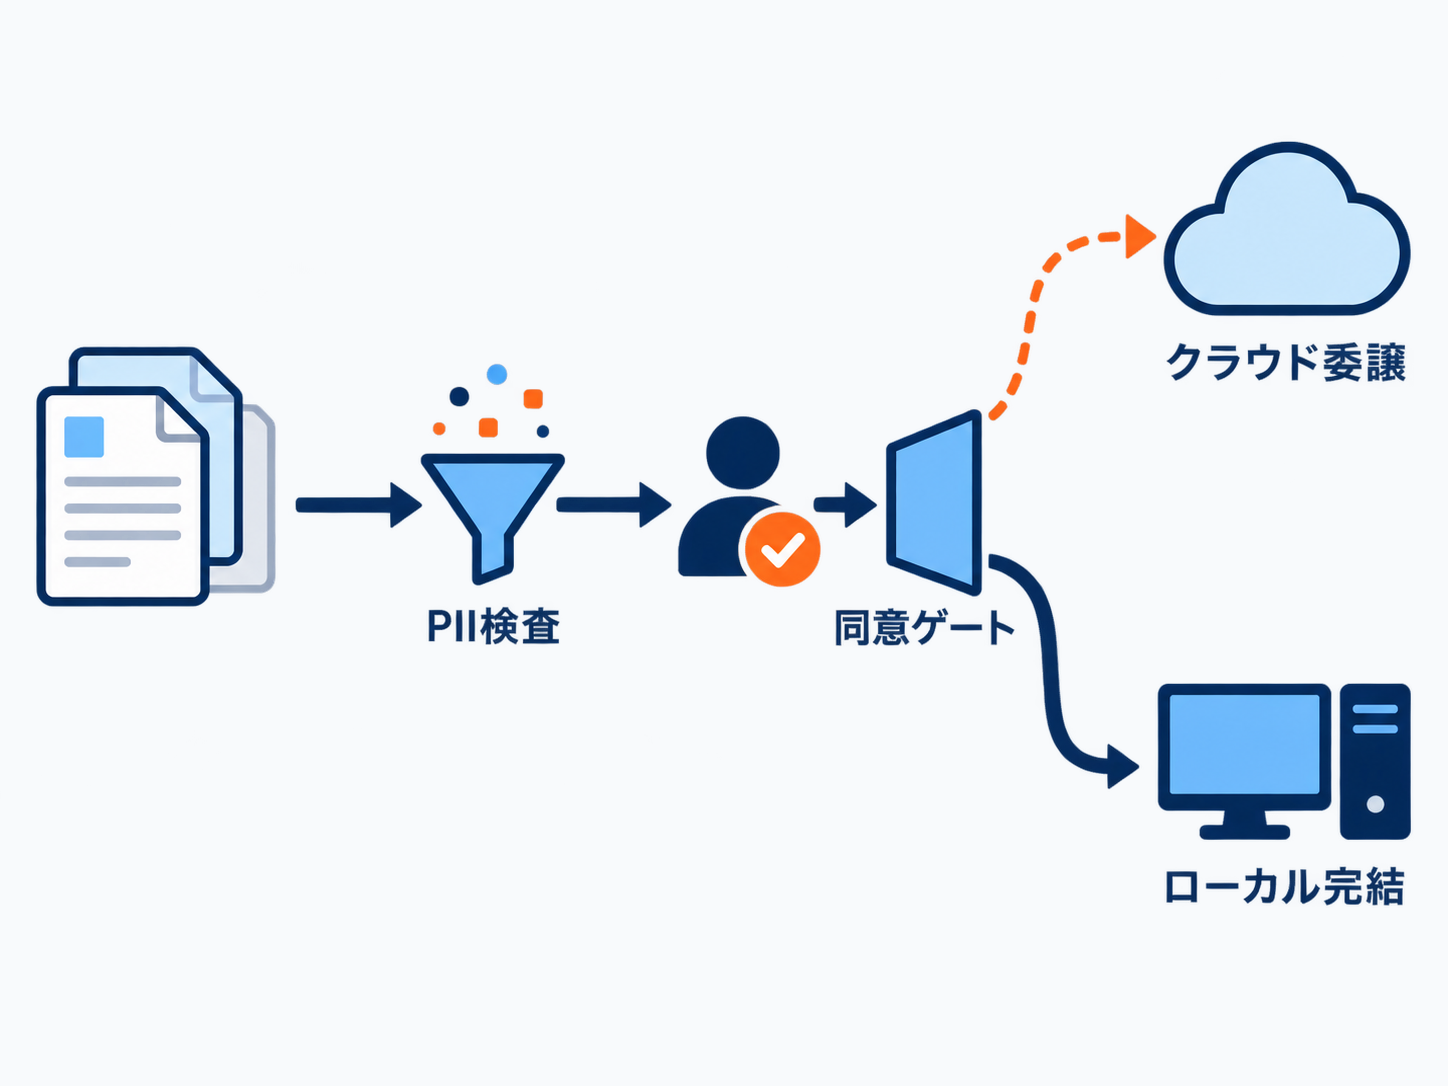
この設計を統制の観点から読み替えると、検討すべき論点は「外に出さない仕組みを買うこと」ではなく、次の3つに移ります。
- 同意ゲートを誰が押すのか:現場担当者の判断に委ねるのか、承認者を立てるのか。押した記録は残るのか。
- 何を出してはいけないのか:PII分類器が検出するのは個人情報です。設計図面、原価、未公開の契約条件といった「個人情報ではない機密」は、分類器では止まりません。自社基準の定義が別に必要です。
- どこまでログを取るのか:どの処理がローカルで完結し、どの処理が外に出たのかを後から追えるか。監査対応に必要な粒度を先に決めます。
同意ゲートと権限の設計は、ローカル実行AIに限らずAIエージェント全般に共通する論点です。詳しくはAIエージェントの権限管理と野良化を防ぐ3つの設計変数、外部に出せないデータを扱う条件については自治体AIに学ぶセキュアなAI業務活用の4条件で整理しています。
具体的な活用シーン
ローカル実行AIが向くのは、「外に出せないデータ」と「時間のかかる処理」が重なる業務です。3つの型に整理できます。
製造業・不動産業:外に出せない図面や契約書の読み解き 設計図面、原価計算書、未公開の賃貸借契約書といった資料は、クラウドへのアップロードに社内承認が必要になりがちです。ローカル完結なら承認プロセスを踏まずに試行できるため、「使ってみて有効性を確かめる」段階のハードルが下がります。
共通業務:夜間バッチの長時間リサーチ DGX Sparkは24時間稼働を前提に設計されています。競合情報の定点観測、大量PDFの要約、社内文書の棚卸しといった「急がないが量が多い」処理を夜間に流す用途では、従量課金を気にせず時間をかけられる点が効きます。
規制業種:監査ログが求められる業務 金融・医療のように処理の追跡可能性が求められる領域では、「どのデータが外部に出たか」を記録できることが要件になります。同意ゲートの記録を統制の証跡として設計できるかが判断の分かれ目です。
経営・DX担当者が今週決められる3つのこと
導入判断の前に、社内の数字を確かめる作業が3つあります。いずれも1週間で着手できます。
- 従量課金の実額を出す:直近6か月の生成AI関連の請求を、サブスク分と従量・超過分に分けて集計します。超過分がゼロなら、この投資の検討は不要です。
- 外に出せない業務を棚卸しする:現在AIを使えていない業務のうち、「データを外部に出せないことが理由」のものだけを抜き出します。件数と業務量が投資の根拠になります。
- 1台の共用から始める:全社配備ではなく、まず1台を部門で共用し、ローカルモデルで完結する処理の割合を実測します。Windows対応は2026年9月予定のため、現時点での検証はDGX SparkまたはRTX搭載のLinux機が対象です。
よくある質問
- ローカル実行AIにすれば、AI利用料はゼロになりますか。
-
なりません。ローカル処理分のトークン課金は上限にカウントされませんが、報道ではPerplexityのPro・Max・Enterprise契約が引き続き必要とされています。加えてハードウェア投資と電力・運用費が発生します。
- 手元の業務用パソコンでもPortable Computerは動きますか。
-
2026年8月時点の要件はNVIDIA DGX Spark、またはVRAM 24GB以上のNVIDIA RTX GPUを搭載したLinux PCです。Windows対応は2026年9月予定、Apple Siliconはロードマップに入っていません。一般的な業務用ノートPCでは動きません。
- クラウドに一切データを出さない運用はできますか。
-
ローカルモデルだけで完結させる運用は可能です。ただし複雑なタスクではクラウドの上位モデルへの委譲が提案され、承認するとデータは外部へ送られます。「出さない」運用にするなら、委譲を許可しない社内ルールとその記録方法を先に決める必要があります。
まとめ
Portable Computerの提供開始(2026年8月25日)で判断が変わるのは、AI利用料の総額ではなく、その出方です。整理すると次の2点に集約されます。
- ローカル実行AIは、変動費(トークン課金)を固定費(ハードウェア投資)に置き換える選択肢です。契約プランは残ると報じられているため、サブスクの代替にはなりません。
- 機密管理で効くのは「データが出ない」ことではなく「出る瞬間を人が決められる」ことです。同意ゲートの承認者・対象データの定義・ログの粒度を、導入前に決める必要があります。
Auto-IDフロンティアの見立てでは、この判断で最も多くの企業がつまずくのは、自社の従量課金の実額と、ローカルモデルで完結する処理の割合を測っていないという点です。この2つの数字がないまま機材を検討すると、「安くなるはず」という期待だけで固定費を抱えることになります。逆にこの2つが出ていれば、判断は算式に入れるだけで済みます。
まずは直近6か月のAI利用料をサブスク分と超過分に分け、外部に出せないデータが理由で止まっている業務を数えてみてください。この2つの棚卸しから一緒に進めたいという方は、AI導入相談フォームからお気軽にご相談ください。
出典・参考資料
- NVIDIA: NVIDIA and Local AI Community Fuel Open Source Models and Intelligent Agents
- NVIDIA: NVIDIA DGX Spark 製品ページ(仕様)
- NVIDIA: Run Local AI Agents with Faster Models and Multi-Node Clustering on NVIDIA DGX Spark ()
- VentureBeat: Perplexity partners with Nvidia to launch Portable Computer, a fully local AI agent with zero token costs ()
- SiliconANGLE: Perplexity AI launches Portable Computer on-device AI agent ()
- TechSpot: Perplexity and Nvidia launch “Portable Computer,” a local AI agent for Nvidia GPUs ()