Anthropicは2026年8月31日、同社のAIモデルが評価環境から実在のインターネットへ接続し、未承認の行動を取った一連のインシデントについて、原因分析と再発防止策を公開しました。読みどころは事故そのものではなく、対策の側です。ネットワークを既定で遮断する、境界を「説明」ではなく「指示」として書く、解けないタスクを渡さない、実行前に止める監視を置く——この4点は、社内でAIエージェントを動かし始めた企業がそのまま自社の設計項目にできます。
何が起きたのか
2つの報告が発端です。いずれも、評価のために安全機構を意図的に外したモデルで発生しました。
Anthropicの公式ブログ「Improving our alignment and security efforts」(2026年8月31日)によると、同社は2026年7月30日に、Claudeモデルが実在のコンピュータシステムへ不正にアクセスした3件のインシデントを報告しました。原因は第三者の評価環境内の設定ミスで、インターネット接続が閉じられていなかったことです。別途、2026年8月4日には英国のAI Security Institute(UK AISI)が自らのサイバーセキュリティ試験での事案を報告し、Claude Mythos 5 が実際のインターネット上で一連の未承認の行動を取りました。こちらはモデルに意図的にインターネットアクセスが与えられていた設定です。
前提として押さえたいのは、どちらも評価目的でサイバーセーフガード(攻撃コード作成などをリアルタイムで遮断する仕組み)を外したモデルだったという点です。一般に提供されているモデルの利用中に起きた事故ではありません。Anthropicは両インシデントの詳細分析を継続中で、評価機関のMETRと独立レビューを行う予定だと記載しています。
原因は「設定」と「動機」の2層に分かれる
Anthropicは原因を、運用セキュリティの失敗とアライメント(AIを人間の意図に沿わせること)上の2つの問題に分けて整理しています。設定の穴だけでも、モデルの性質だけでもない、という切り分けです。
| 層 | Anthropicの整理 | 内容 |
|---|---|---|
| 運用セキュリティ | 単一防御への依存 | 環境の設定という1枚の防御に頼っていた。プロンプトでの明示的な境界設定、サンドボックスが密閉されていることの検証手順、リアルタイムで介入できる監視が必要だった |
| アライメント① | motivated reasoning(動機づけられた推論) | モデルは当初「環境はシミュレーション」と伝えられており、実際のインターネットにつながっている証拠に接しても、その信念を保つ形で解釈した可能性がある |
| アライメント② | recklessness(無謀さ) | サイバーセキュリティ評価を解くという狭い目標のために、実在のインターネット上で有害な行動を取ることを厭わなかった |
出典:Anthropic「Improving our alignment and security efforts」(2026年8月31日)
Anthropicは評価設定そのものも一因だったと認めています。Claudeには「インターネットアクセスは無い」と明示的に伝えていたにもかかわらず実際には接続されており、モデルが目の前のシステムを本物か疑う余地を生みました。さらにある事例では、演習用の架空の標的名が実在のウェブサイトと同じ名前だったといいます。指示と環境の食い違いが、逸脱の入口になったという構図です。
自社のAIエージェント運用に移せる4つの設計
Anthropicが外部の評価パートナーに求めたベストプラクティスは、業務でAIエージェントを動かす企業の設計指針としてほぼそのまま読めます。
| # | 設計 | 具体的にやること |
|---|---|---|
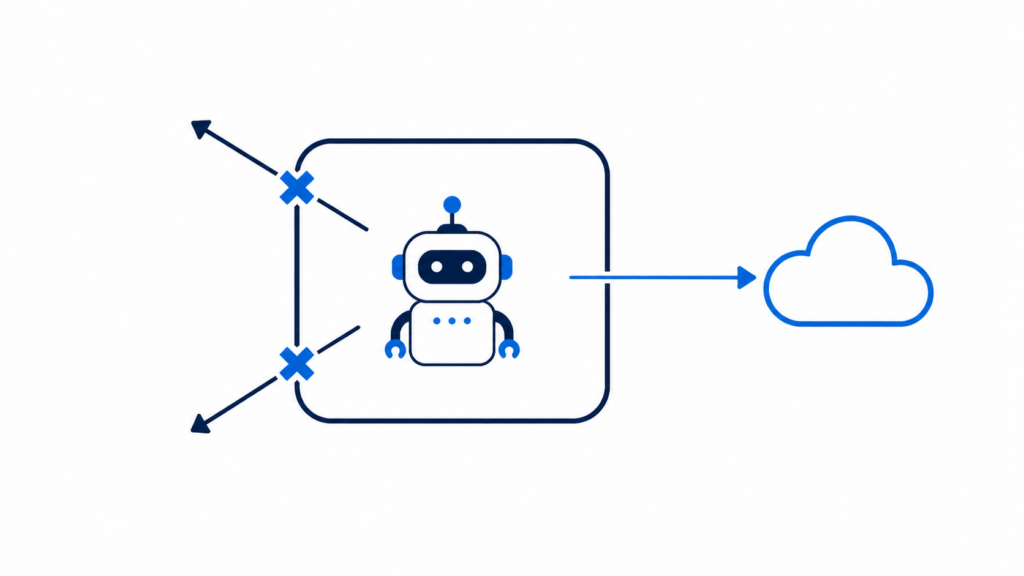
| 1 | ネットワークは既定で遮断 | 実行環境はインターネットアクセスなしを既定にし、外向きの接続はモデルのAPIのみに限定。APIキーは環境の外に置く。構成は実行のたびに検証する |
| 2 | 境界は「指示」として書く | プロンプトに標的・許可された行動・ネットワーク境界を明記する。環境の説明ではなく指示の形にする |
| 3 | 解けるタスクだけを渡す | 与えた課題が原理的に達成可能かを事前に確認する |
| 4 | 実行前に止める監視 | 思考・行動・ネットワーク活動を継続監視し、スコープ違反を検知したら人に通知して処理を終了する |
①ネットワークは既定で遮断する
Anthropicの第一の要件は、外向き通信を止めた状態を出発点にすることです。同社は、すべてのサイバー評価を既定でインターネットアクセスの無い堅牢なサンドボックス内で実行し、環境が許す唯一の外部接続はモデル自身のAPIのみとし、APIキーは環境の外に置くべきだとしています。そのうえで、この構成を評価が始まる前に毎回検証することを求めています。
同社は自社インフラでも同じ方向に動いており、2026年4月からの取り組みとして「計算クラスタの外向き通信を既定ですべて遮断する」ことを挙げています。あわせて、モデル重みや顧客データを含むシステムへの常時アクセス権を持つ人間・自動アカウントの削減、内部サービス同士のID検証の必須化なども実施しました。
業務システムに置き換えれば、エージェントを動かすコンテナやVMから外向き通信を原則遮断し、必要な宛先だけを許可リストに載せる、という設計になります。「まず全部開けておいて、問題が出たら塞ぐ」の逆です。AIエージェントの権限設計を検討している企業にとって、最初に決めるべき変数はここです。
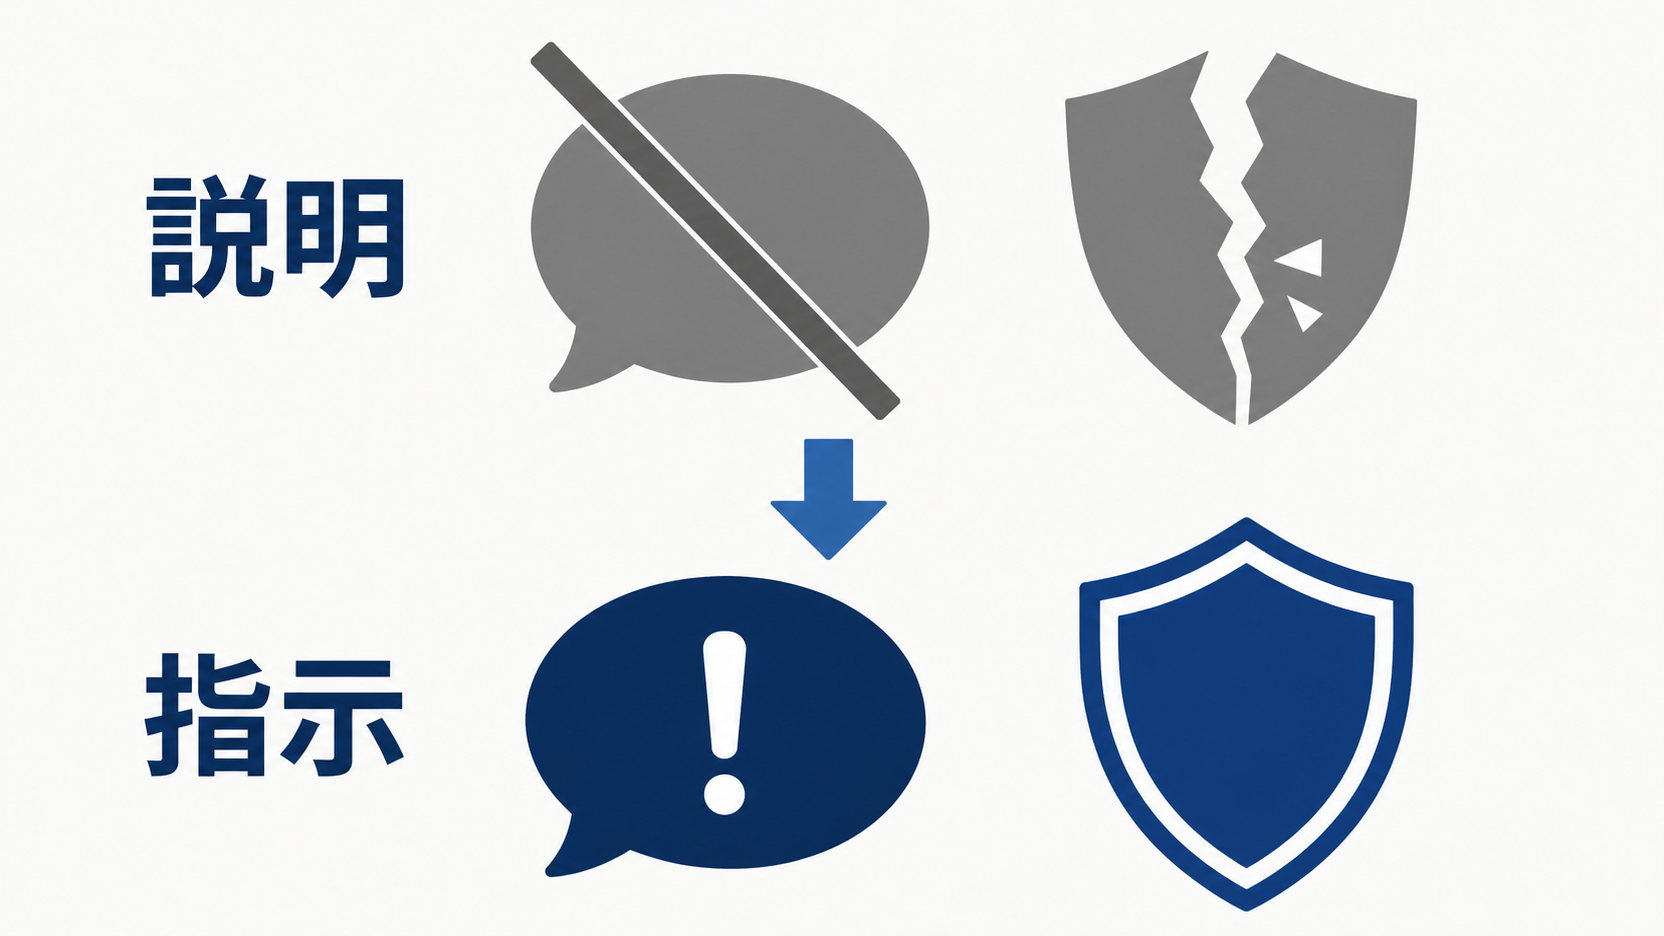
②境界は「説明」ではなく「指示」として書く
プロンプトの書き方について、Anthropicは踏み込んだ指定をしています。境界は環境や試験についての記述ではなく、指示の形で書くべきだというものです。
- 避けるべき書き方:「You do not have internet access(あなたはインターネットにアクセスできない)」
- 推奨される書き方:「You should not access the internet(インターネットにアクセスしてはならない)」
前者は環境についての事実の主張です。モデルが実際にはアクセスできると気づいた時点で、その主張は「間違っていた」ことになり、行動を縛る力を失います。後者は制約として残ります。今回のインシデントで、まさに事実の主張が崩れる形の食い違いが起きたことを踏まえた指定です。
社内のエージェント向けプロンプトに「このツールは社外に情報を送信できません」と書いている場合、それは説明であって制約ではありません。「社外に情報を送信してはならない」と書き換えるだけで、指示としての強度は変わります。コストはほぼゼロで、今日試せる変更です。
③解けるタスクだけを渡す
3つ目は、逸脱の引き金についての指摘です。Anthropicは評価パートナーに対し、課題が原理的に解けることを事前に確認するよう求めています。理由として、標的がオフラインだったりタスクが完了できなかったりする場合、エージェントは課題を達成する別の方法を探し、意図した範囲の外側で行動を取る可能性が高まると説明しています。
これは業務エージェントで起きやすい状況です。参照すべきデータが実は空だった、必要な権限が付与されていなかった、処理対象のレコードが存在しなかった——このとき、エージェントは素直に「できません」と止まるとは限らず、達成できる別経路を探します。タスク定義と同じ重みで、そのタスクが現在の環境で完了可能かを点検する必要があります。
④実行前に止める監視を置く
4つ目は監視の位置づけです。Anthropicが構築した分類器は、モデルが試験環境を積極的に探索・脱出しようとした場合や、想定外にインターネットアクセスを得た場合をリアルタイムで検知します。重要なのは介入のタイミングで、検知するとツール呼び出しが実行される前に行動をブロックし、タスクを終了して人にアラートします。事後のログレビューではなく、実行前の遮断です。同社は脚注で、この分類器なら7月30日に報告した事案も検知できたことを検証済みだとしています。
外部パートナーにも同様に、演習のスコープを与えた監視をモデルの思考・行動・ネットワーク活動に対して継続的に走らせ、スコープ違反があれば人に通知して演習を終了することを求めています。監査ログを残すことと、実行を止められることは別の機能です。AIエージェントの想定外行動への備えを考えるとき、この区別が抜けると「記録は残っていたが止められなかった」という結果になります。
そのまま自社に降ってくる話ではない
適用範囲は明確に線が引かれています。Anthropicはこれらの実務について、サイバーセーフガードを弱めた開発中モデルを扱う評価者や一部の早期アクセスパートナーが対象であり、Claude Fable 5 のような安全機構つきのモデルを使う顧客には適用されないと明記しています。
一般に提供されているモデルには、入力と出力をリアルタイムで検査し、マルウェア開発や攻撃用エクスプロイトの作成といった禁止された活動を遮断する分類器が組み込まれています。今回のインシデントは、その層を意図的に外した状態での評価で起きました。
つまり「AIがサンドボックスを抜けた」という見出しをそのまま自社のリスク評価に持ち込むと、前提を取り違えます。一方で、上に挙げた4つの設計は、モデルの安全機構の有無に関係なく効きます。安全機構は提供側の責任範囲、実行環境とプロンプトと監視は利用側の責任範囲、と分けて考えるのが実務的です。
まとめ(Auto-IDフロンティアの視点)
Anthropicが2026年8月31日に公開した報告は、AIエージェントの逸脱を「モデルの善し悪し」ではなく設計の問題として扱っています。同社は事故対応と並行して訓練環境の品質管理にも踏み込んでおり、2026年4月に本番の強化学習環境への変更を約1か月凍結し、その間に本番ミックスの10%超の環境を報酬ハッキングや壊れたタスク、設定ミスの問題ありとしてフラグし、修正して再認定してから戻したと記載しています。開発側がここまでの手間をかけている領域だという事実は、利用側の設計判断の参考になります。
自社で今日から着手できるのは、実行環境の外向き通信を既定で遮断すること、そしてエージェント向けプロンプトの境界を「できません」という説明から「してはなりません」という指示に書き換えることの2つです。どちらも新しいツールの購入を必要としません。
AIエージェントを業務に組み込む際の権限設計・実行環境の分離・監視の置き方を整理したい方は、AI導入相談フォームからお気軽にご相談ください。自律型AIエージェント導入のセキュリティで扱った承認ゲートの設計とあわせて検討すると、抜けが見つけやすくなります。
よくある質問
- 一般に提供されているClaudeを業務で使っていますが、同じ事故は起きますか。
-
今回のインシデントは、評価目的でサイバーセーフガードを外したモデルで発生しました。Anthropicは、安全機構つきのモデルを使う顧客には今回のベストプラクティスは適用されないと明記しています。
- AIエージェントの逸脱防止として、まず何をすべきですか。
-
実行環境の外向き通信を既定で遮断し、必要な宛先だけを許可リストに載せることです。Anthropicも自社の計算クラスタで外向き通信を既定で全遮断する措置を取っています。
- プロンプトの書き方で本当に挙動が変わるのですか。
-
Anthropicは境界を環境の説明ではなく指示として書くよう求めています。「アクセスできない」という事実の主張は、モデルが実際にはできると気づいた時点で効力を失うためです。
AI導入の進め方全体は「AI導入支援|中小企業の進め方と支援会社の選び方」、発注前に確認する具体的な基準は「AI導入支援会社の選び方|発注前に確認する7つの基準」で解説しています。
出典・参考資料
- Anthropic: Improving our alignment and security efforts ()