Anthropicが2026年9月28日に公開した中位モデル「Claude Sonnet 5.5」は、API単価が入力100万トークンあたり$2・出力$10です。これは前世代のClaude Sonnet 5とまったく同額で、値下げはありません。一方でAnthropicは「1タスクあたり最大30%安い」と説明しています。安くなるのは単価ではなく、1つの仕事を終えるまでに消費するトークン量です。請求額が実際に下がるかどうかは、自社の使い方で決まります。
2026年9月28日に発表された内容
Anthropicは2026年9月28日、Claude 5.5ファミリーの2番目のモデルとしてClaude Sonnet 5.5(モデルID `claude-sonnet-5-5`)を公開しました。上位のClaude Opus 5.5と、近日公開とされるClaude Haiku 5.5の中間に位置する階層です。
Anthropicの公式価格ページに掲載されたClaude Sonnet 5.5の単価は次のとおりです(100万トークンあたり、2026年10月2日時点)。
| 項目 | Claude Sonnet 5.5 | Claude Sonnet 5 |
|---|---|---|
| 入力 | $2 | $2 |
| 出力 | $10 | $10 |
| キャッシュ読み取り | $0.20 | $0.20 |
| キャッシュ書き込み(5分) | $2.50 | $2.50 |
| キャッシュ書き込み(1時間) | $4 | $4 |
| Batch API(入力/出力) | $1/$5 | $1/$5 |
6項目すべてが一致しています。なおClaude Sonnet 5の$2/$10は当初2026年8月31日までの導入価格でしたが、9月1日に予定されていた$3/$15への引き上げは実施されず、そのまま標準価格になりました(この経緯は「Claude Sonnet 5の価格が確定|AI運用コスト見直しの4施策」で整理しています)。
「最大30%安」は単価ではなくトークン消費量の話
Anthropicの公式表現は「1タスクあたり最大30%安い(costs up to 30% less per task)」です。単価は据え置きなので、削減の源泉はモデルが消費するトークン数とツール呼び出し回数の減少にあります。
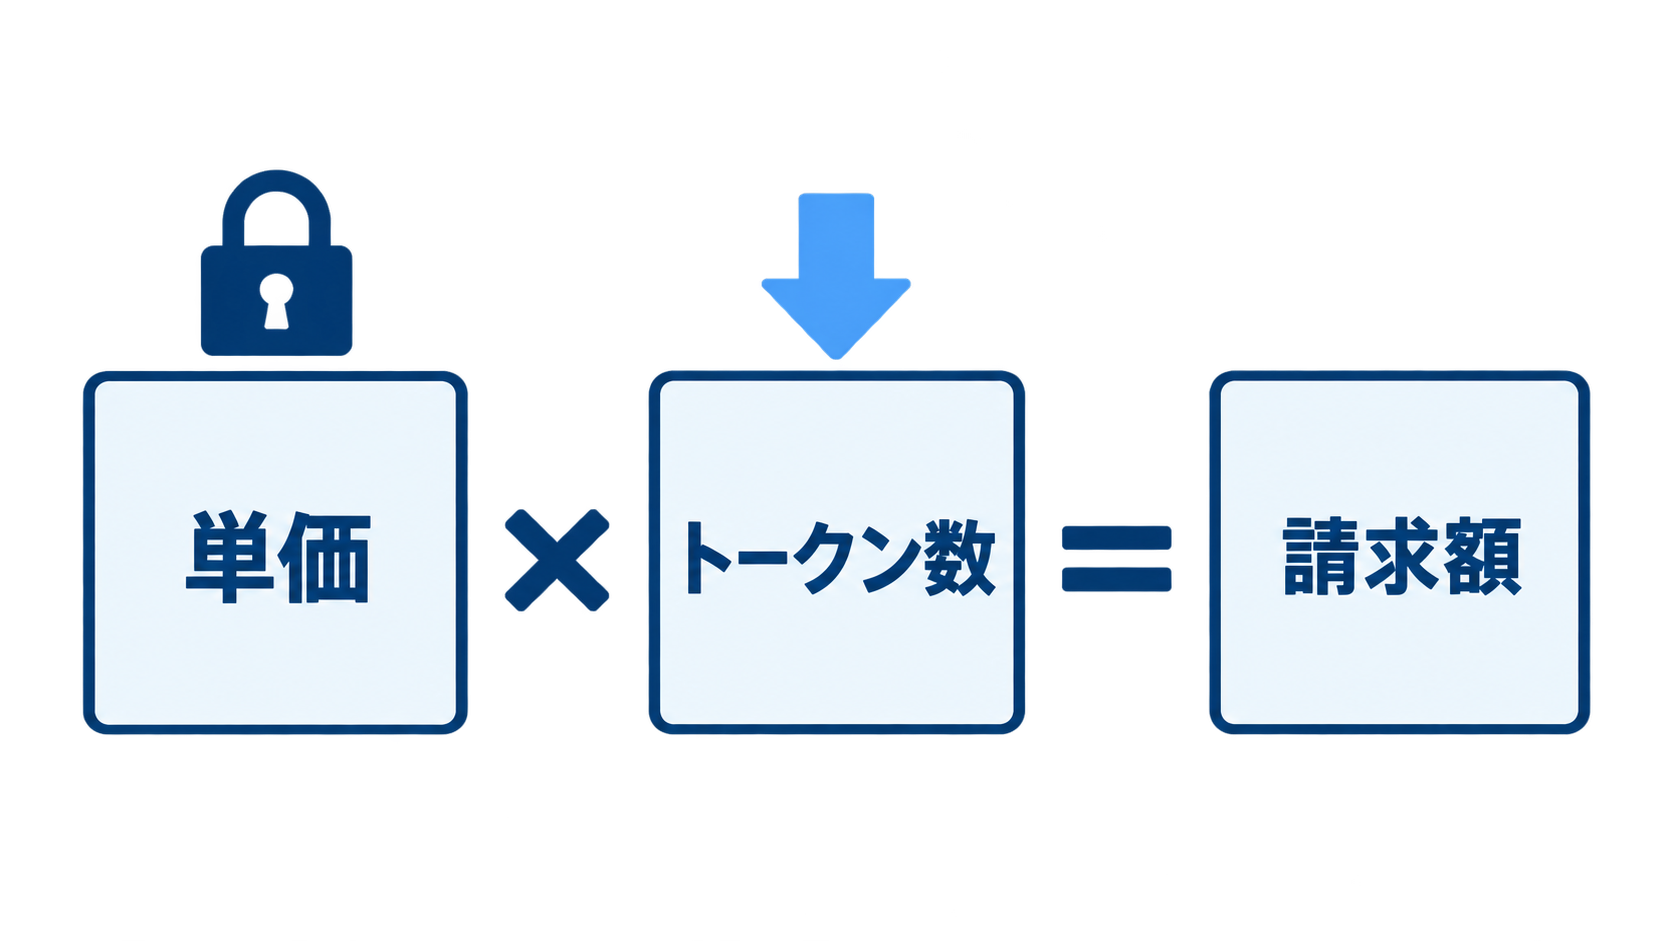
API利用料は次の式で決まります。
請求額 = 単価 × 消費トークン数
Claude Sonnet 5.5で動いたのは右側の項だけです。左側の単価は1ドルも動いていません。したがって「値下げされたから自動的に安くなる」ことはなく、自社のワークロードでトークン数が実際に減るかどうかが条件になります。同じ構図は過去にも起きています。出力単価が4割下がったモデルでも請求が4割減らない理由は「出力単価4割減でも請求は4割減らない|Fugu Max検算」で検算しました。単価と請求額は別の変数です。
速度についてAnthropicは「出力生成がSonnet 5より30%以上速い」と述べています。処理時間の短縮は人の待ち時間とインフラ稼働時間に効きますが、トークン課金そのものには直結しません。
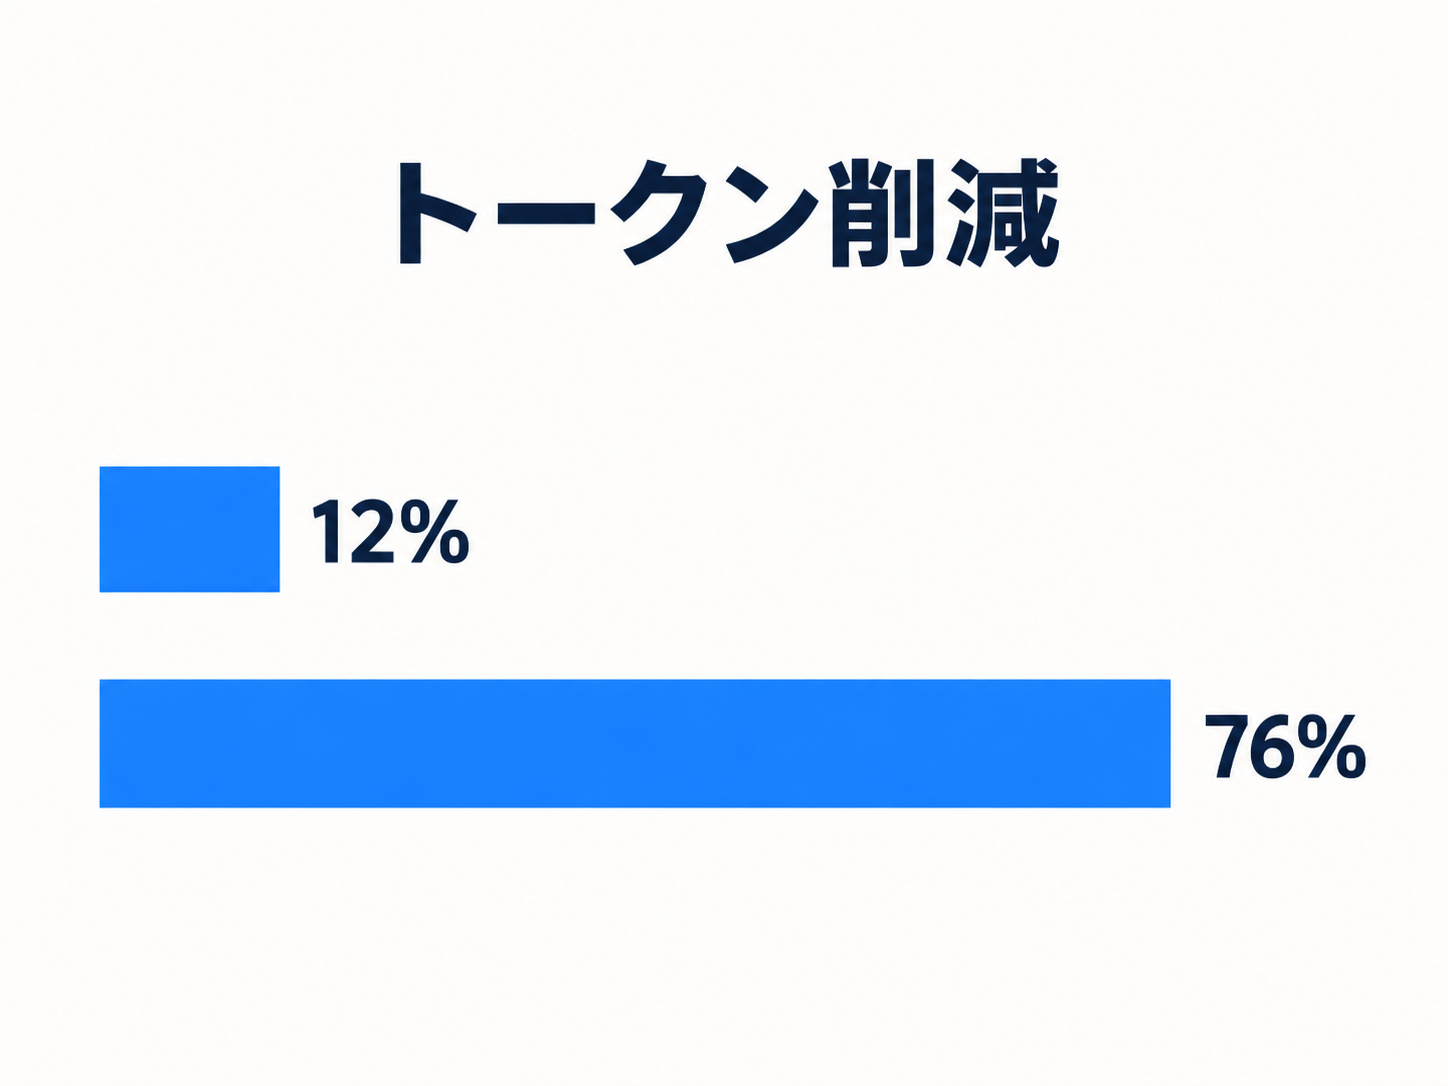
削減幅は12%〜76%と大きくばらつく
Anthropicが公式ページに掲載した顧客報告を並べると、トークン削減の幅は企業ごとに大きく異なります。「最大30%」という数字を自社の予算前提に使うのは危険です。
| 企業 | 公表された内容 |
|---|---|
| Balyasny Asset Management | 1回答あたり約121kトークン(Claude Sonnet 5は497k)=約76%減 |
| Box | 精度が向上し、2.4倍高速、総トークン12%減 |
| Base44 | 1ビルドあたり3.6イテレーション(Claude Opus 5は7.7) |
| Zendesk | チケット処理が20%高速 |
同じモデル間の比較で、トークン削減が12%の企業と76%の企業が並んでいます。差を生むのはワークロードの形です。長い社内文書を毎回まるごと投げる処理と、短い問い合わせに短く答える処理では、トークン効率の改善が効く余地がまったく違います。
Anthropicの公表値によれば、ベンチマークではTerminal-Bench 4.0が70.6%(Claude Sonnet 5は10.3%)、OSWorld 2.1が80.1%(57.0%)、CursorBench 4.0が55.5%(34.1%)、知識労働を評価するGDPval-AA v2.1が1844(1449)です。いずれもベンダー自身の測定値であり、第三者検証ではありません。またAnthropicは「複雑で終わりの見えにくい仕事ではClaude Opus 5.5のほうが明確に強い」とも明記しています。
主力階層の単価は$2/$10で横並びになった
実運用で最も使われる中位階層の単価は、AnthropicとOpenAIで同額になりました。価格表を比べて安い方を選ぶ、という判断がこの階層では成立しなくなっています。
| モデル | 入力 | 出力 | キャッシュ入力 |
|---|---|---|---|
| Claude Sonnet 5.5(Anthropic) | $2 | $10 | $0.20 |
| GPT-6 Sol(OpenAI) | $2 | $10 | $0.20 |
| GPT-6.1 Sol(OpenAI) | $2 | $10 | $0.10 |
OpenAI側の数値はOpenAIの公式価格ページの短コンテキスト標準料金です。単価が同じなら、残る比較軸は「同じ仕事を終えるのに何トークン使うか」と「何回やり直すか」になります。モデル選定の評価項目を、単価表からタスク単価の実測へ移す必要があります。
経営・DX担当者が先に決める4項目
Claude Sonnet 5.5への切り替えを検討する前に、自社の測り方を決めておくことが先です。測る仕組みがないまま乗り換えると、安くなったのか高くなったのかが分かりません。
- 比較単位を「1タスクあたりの金額」にする。月額総額だけを見ていると、利用件数の増減とモデル効率の改善が混ざって判別できません。業務1件あたりの入力・出力トークン数を記録する項目をログに足します。
- キャッシュ読み取り$0.20を使えているか確認する。Claude Sonnet 5.5のキャッシュ読み取りは入力単価の10分の1です。社内規程やマニュアルのような固定の前置きを毎回フルで送っている処理は、ここだけで大きく変わります(詳細は「AI運用費はキャッシュで決まる|Fable 5.1が示す4分の1」)。
- 即時応答が不要な処理をBatch APIへ切り分ける。Claude Sonnet 5.5のBatch単価は入力$1・出力$5で、標準の半額です。夜間の一括要約や過去データの再分類は候補になります。
- 上位モデルとの役割分担を決める。Anthropic自身が複雑な業務ではClaude Opus 5.5が強いと認めています。全処理を中位モデルに寄せるのではなく、「どの業務をどの階層に出すか」を業務単位で割り当てます。
具体的な活用シーン
Claude Sonnet 5.5が効きやすいのは、仕様がはっきりしていて繰り返し発生する業務です。Anthropicはこのモデルを「範囲が明確な日常業務、バグ修正、仕上げた文書の作成」向けと位置づけています。
- 社内問い合わせ対応:就業規則や経費精算ルールへの回答。固定の規程をキャッシュに載せ、質問文だけを毎回送る構成にすると、1件あたりの入力トークンが安定します。
- 定型文書の作成・校正:見積書の説明文、報告書の下書き、取引先向け案内文。出力が長くなりがちな処理なので、出力$10の削減余地を測る対象になります。
- コード修正の一次対応:軽微なバグ修正や設定変更。Base44の報告にあるようにイテレーション回数が減れば、同じ修正にかかる回数分のトークンがそのまま減ります。
いずれの用途でも、切り替え前に同一の入力で前世代と比較し、トークン数を実測してから本番に移すのが安全です。
よくある質問
- Claude Sonnet 5.5は値下げされたのですか。
-
単価は値下げされていません。入力$2・出力$10・キャッシュ読み取り$0.20はClaude Sonnet 5と同額です。Anthropicが示す「最大30%安」は1タスクあたりの消費トークン減による効果で、単価の変更ではありません。
- Claude Sonnet 5から乗り換えると請求額は必ず下がりますか。
-
必ず下がるとは言えません。Anthropic公式ページの顧客報告では総トークン削減が12%の企業と約76%の企業が併記されており、幅が大きいためです。自社の代表的な業務で実測してから判断してください。
- AI運用コストを測るには何を記録すればよいですか。
-
業務1件あたりの入力トークン数・出力トークン数・やり直し回数の3点です。月額総額だけでは、利用件数の増加とモデル効率の改善が区別できず、切り替えの効果を判定できません。
- OpenAIのモデルと単価が同じなら何で選ぶのですか。
-
同じ仕事を終えるまでに消費するトークン数と、やり直しの発生率です。主力階層は入力$2・出力$10で横並びになったため、価格表ではなく自社業務での実測が選定根拠になります。
まとめ
Claude Sonnet 5.5の料金は入力$2・出力$10で、Claude Sonnet 5から据え置きです。Anthropicが示す「1タスクあたり最大30%安」はトークン消費量の削減によるもので、単価の値下げではありません。公式に掲載された顧客報告では削減幅が12%から約76%まで開いており、自社の請求額がどう動くかは実測しないと分かりません。さらに中位階層の単価はOpenAIのGPT-6 Sol・GPT-6.1 Solと同額になり、価格表で選ぶ余地は消えました。
Auto-IDフロンティアの見方は、モデルが更新されるたびに単価表を追うのではなく、自社の「1タスクあたりトークン数」を記録する仕組みを先に作ることが費用管理の本体だというものです。測る土台があれば、次のモデルが出たときの判断は数日で済みます。
次に取るべきアクションは、代表的な業務を1つ選び、現行モデルでの1件あたりトークン数を1週間記録することです。AI利用料の内訳が見えない、どの業務をどのモデルに割り当てるべきか判断できないという場合は、AI導入相談フォームからご相談ください。現在の使い方の棚卸しからお手伝いします。
出典・参考資料
- Anthropic: Claude Sonnet 5.5 ()
- Anthropic: Pricing
- OpenAI: API Pricing
- MarkTechPost: Anthropic Releases Claude Sonnet 5.5: 70.6% on Terminal-Bench 4.0 at the Same $2/$10 Price () (「削減は単価ではなくトークン効率」の明示)
- unite.ai: Anthropic Releases Claude Sonnet 5.5 at Unchanged Sonnet 5 Pricing ()