デジタル庁が、Excel・CSVファイルの機械可読性を100点満点で採点する判定ツール「Harunobu(はるのぶ)」の解説ページを公開しました(親ページの最終更新日は2026年10月21日)。社内のExcelをRAGやAIエージェントに読ませる前に、「何がAIにとって読みにくいのか」を機械的に洗い出せます。ただし判定基準は行政データ向けで、公式自身が誤検知しやすいケースを明記しています。使える範囲と使えない範囲を、一次情報から整理します。
Harunobuは「AIがExcelを読めない理由」を30ルールで採点する
Harunobuは、Excel・CSVファイルを「行政データにおける機械可読性に関するルール」に照らして決定論的に100点満点で採点するツールです。デジタル庁のFact & Data Unitが開発し、GitHubで公開されています。
ルール本体は2026年3月31日に決定されたもので、デジタル庁の解説ページによると3段階のレベルに整理されています。
| レベル | 到達状態 | ルール数 |
|---|---|---|
| L1 | 閲覧・転記可能(表形式でコンピュータが認識できる) | 15 |
| L2 | 集計・分析可能(データ型が明確で欠損値処理が統一されている) | 6 |
| L3 | 連携・自動化可能(標準コード体系とメタデータが整備されている) | 9 |
全30ルールです。採点は3つのモードから選べ、`lite` はL1のみ、既定の `standard` はL1+L2、`thorough` はL1+L2+L3を対象とします。結果はレベルごとに「L1で100点、L2で40点、L3で0点」のように出力され、違反したルール・違反箇所・理由が一覧で表示されます。
利用形態は、ブラウザで使うStreamlit UI、コマンドライン(`uv run harunobu analyze data.xlsx`)、プログラムから呼び出すPython APIの3つで、判定ロジックは共通です。動作環境はWindows・macOS・Linuxで、Python 3.10以上とメモリ1GB以上(大規模ファイルは2GB以上推奨)が必要です。ライセンスは、ルール記載ファイルが公共データ利用規約第1.0版(PDL1.0)、ツール本体がMITライセンスです。
8つのルールは1つ違反で「強制0点」
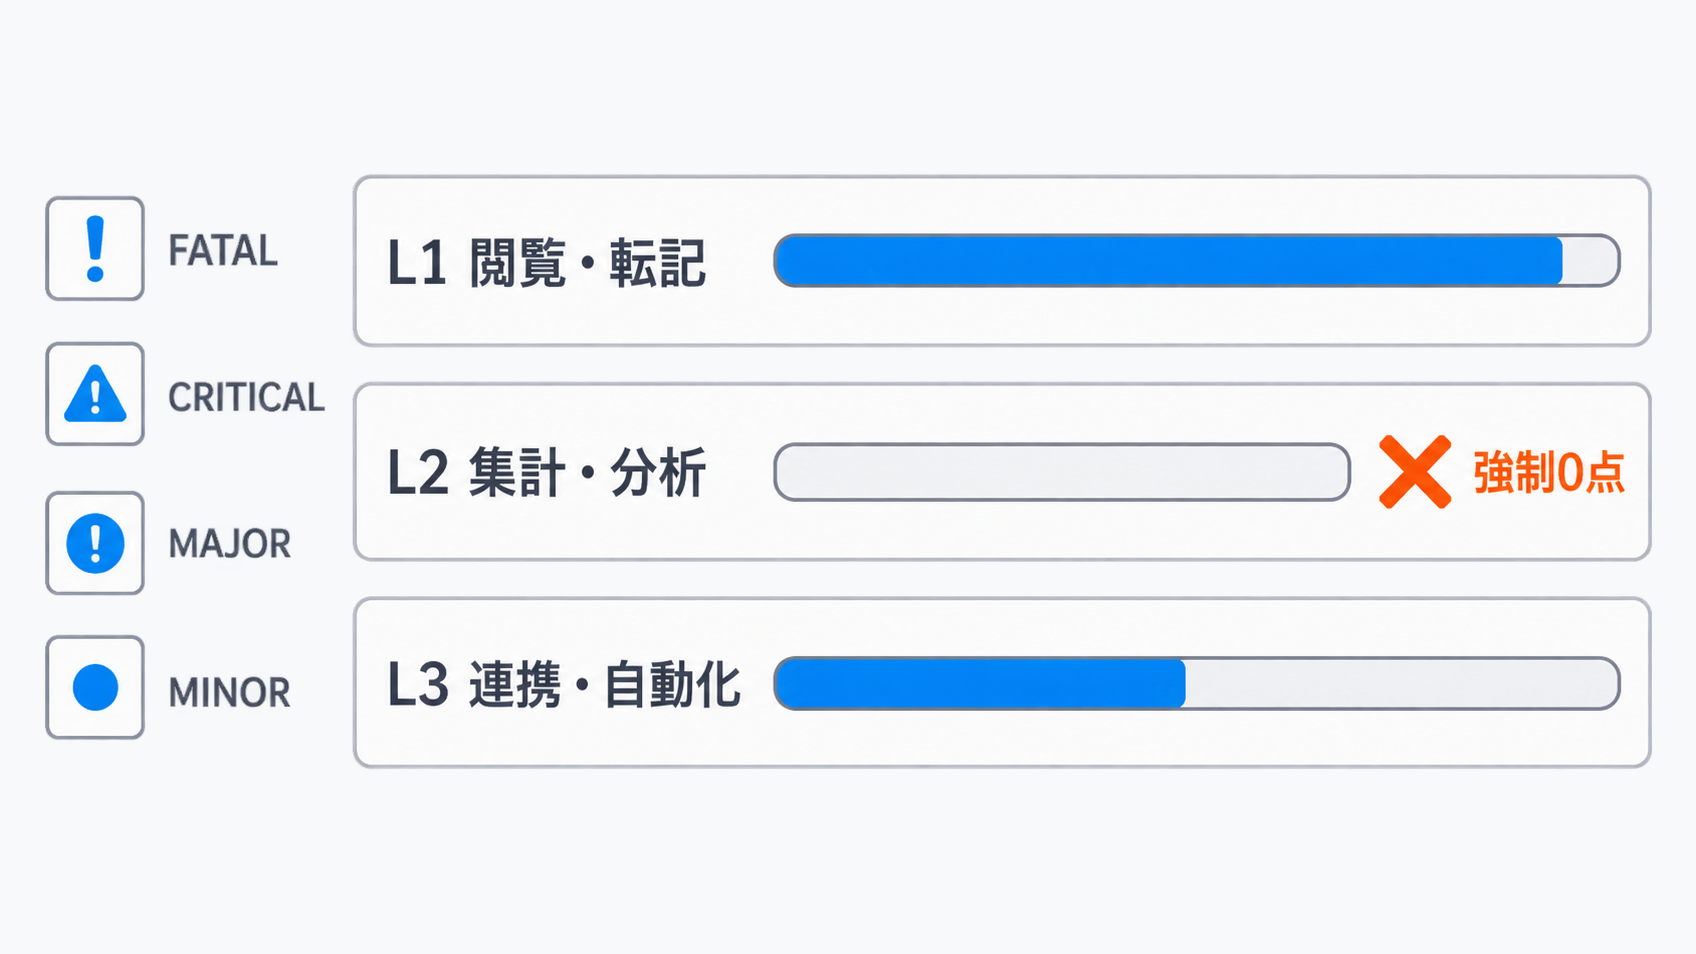
Harunobuの配点は、各ルールに割り当てられた重大度(FATAL/CRITICAL/MAJOR/MINOR)で決まります。このうちFATALに該当する8ルールは、1つでも違反すると強制0点になります。減点ではなく、そのレベルのスコアが0になる扱いです。
| ルールID | 内容 | レベル |
|---|---|---|
| L1-01 | ファイル形式が機械で直接読み取れるExcelやCSV等か | L1 |
| L1-02 | 1シート(CSVは1ファイル)に複数の表を載せていないか | L1 |
| L1-14 | 【CSV】1行1データで表現されているか | L1 |
| L1-15 | 【CSV】カンマを含むフィールドをダブルクォートで囲んでいるか | L1 |
| L2-01 | 数値データが数値属性で、文字列を含まないか | L2 |
| L2-02 | データ内で項目名等を省略していないか | L2 |
| L2-03 | 各列が一意に識別可能な項目名を持っているか | L2 |
| L3-01 | 項目名行から始まり、次の行からデータが入力されているか | L3 |
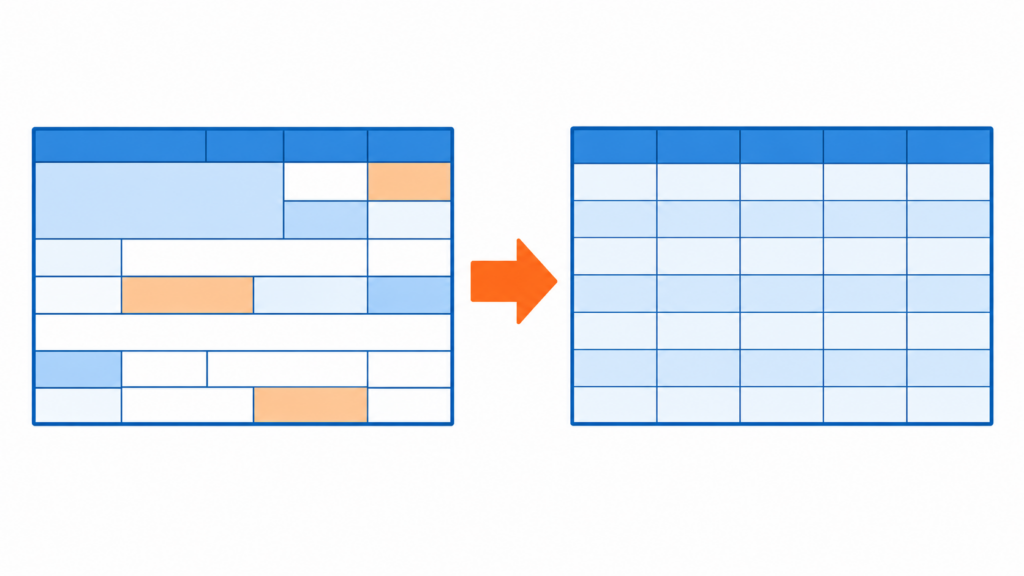
実務で引っかかりやすいのはL1-02とL2-02です。1枚のシートに表を2つ並べる、年度列を「同」「〃」で省略する——どちらも社内Excelでは珍しくない書き方ですが、Harunobuの基準ではそのレベルが0点になります。
社内Excelで先に潰すのはL1の9ルール
社内データをAIに読ませる目的であれば、まず見るべきはL1(閲覧・転記可能)の15ルールです。AIがExcelを読み違える原因の多くがここに集まっています。うちCRITICAL(違反1件あたり-10点)は次の9ルールです。
- L1-12 セルの結合をしていないか:結合セルは、表をプログラムで読むと空セルとして扱われます
- L1-07 1セル1データとなっているか:「東京都千代田区(本社)」のように1セルに複数の情報を詰めない
- L1-11 書式でデータの違いを表現していないか:赤文字・太字・背景色で意味を区別しても、テキストとして読み出したAIには一切伝わりません
- L1-13 不要な行や列が非表示のまま残されていないか:非表示の行はプログラムからは見えます。人が見ている表と、AIが読む表がずれます
- L1-05 すべての列に意味が推測できる項目名が存在するか
- L1-06 スペースや改行等で体裁を整えていないか
- L1-03 データが分断されていないか
- L1-08 機種依存文字を使用していないか
- L1-10 【Excel】オブジェクトを使用していないか
これらは「AIに読ませるためのルール」として作られたものではありませんが、RAG(社内文書を検索して回答に使う技術)やAIエージェントにExcelを渡すときの失敗要因とほぼ重なります。GitHubのREADMEも、結果ファイルを「AI等で修正作業を効率化する際のAIへの指示書としても活用されることを想定」していると書いています。
使う前に知っておく3つの限界
Harunobuは行政データの品質基準を機械判定するツールであり、社内データの点検にそのまま流用すると判断を誤る部分があります。公式が既知の制限事項として明記している内容から、特に影響が大きい3点を挙げます。
1. タイトル行や出典注釈が「違反」になる
L1-04(データ範囲外情報チェック)は、推定した表領域の外に置かれたセルがあれば違反と判定します。公式は「意味的に『無関係』かどうかの判定は行わず、テーブル外に配置されている時点で違反扱いとする厳しい判定」と説明し、誤検知しやすいケースとして「タイトル行・出典注釈を持つファイル」を自ら挙げています。表の上に「2026年度 売上集計」と1行あるだけで減点されます。小計行や区切り行として空白行を挿入している集計表も、L1-03(データ分断チェック)で違反になります。
2. 4つのルールは最初から判定していない
L3-02(回答のコード表が別添されているか)、L3-03(特殊記号の定義を明記しているか)、L3-08(データの定義や更新履歴が記載されているか)は、自動検出の精度が低いという理由で判定対象外です。L3-07(年によるフォーマット変動)は、複数ファイルを一括アップロードしたときのみ評価されます。いずれも常にパス扱いで、スコアには影響しません。点数が高いことは、これらの項目に問題がないことを意味しません。
3. AI補完をONにすると、ローカル完結ではなくなる
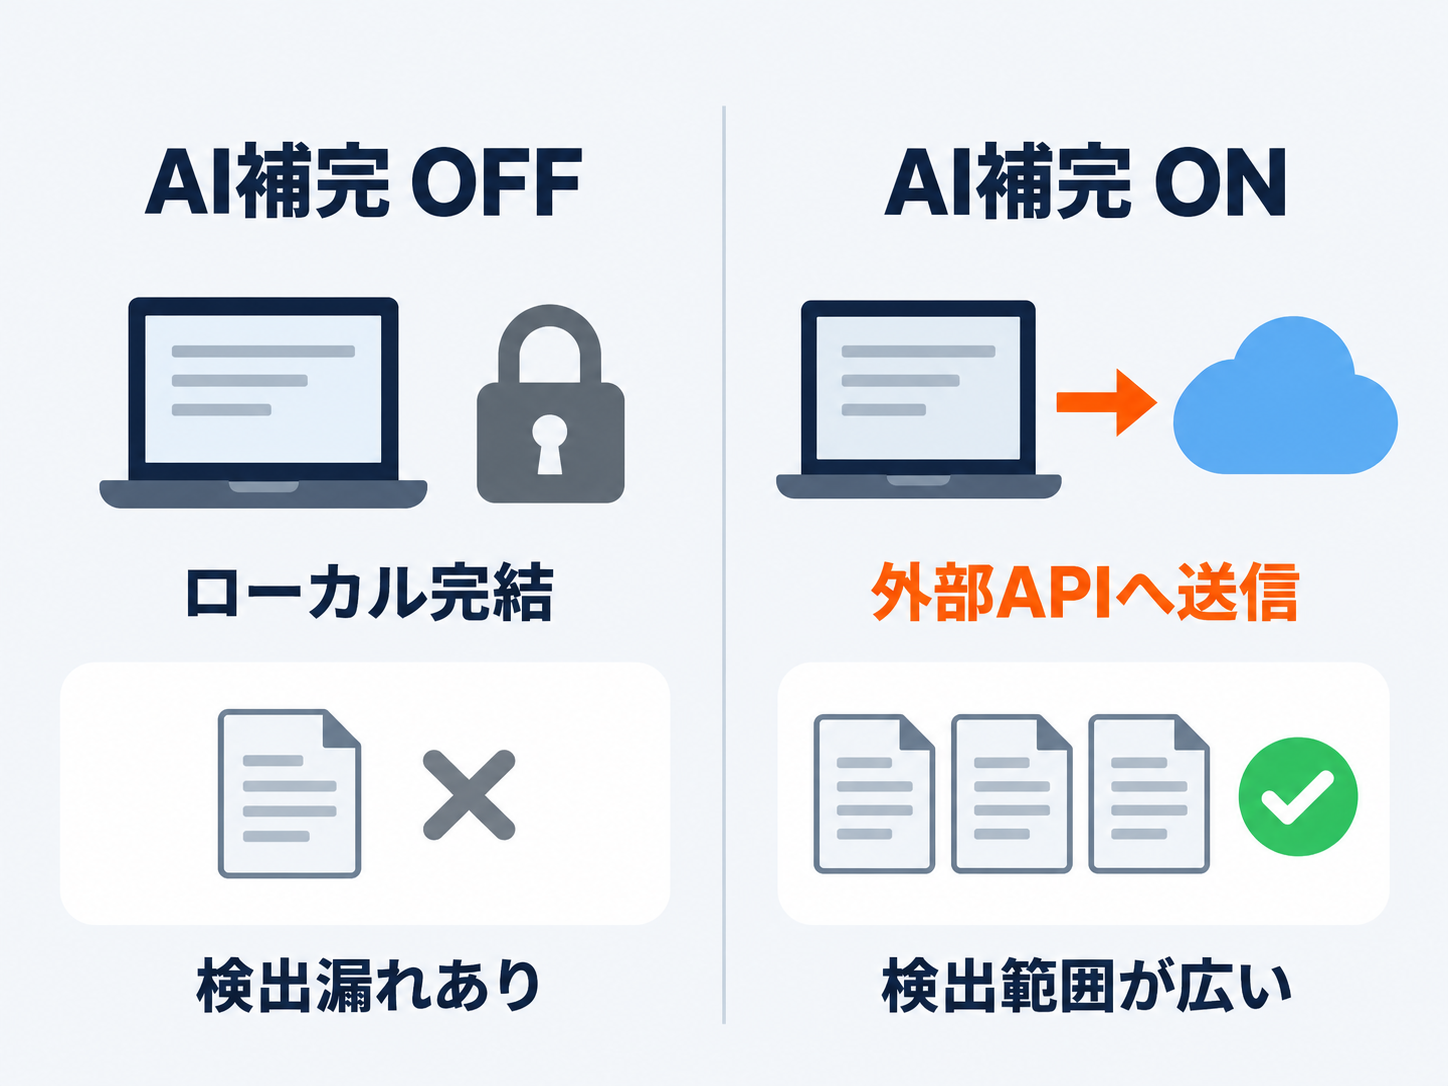
Harunobuはローカル環境で動作し、読み込ませたファイルの内容が外部サーバーへ送信されることはありません。社内データを扱ううえでの最大の利点です。ただし任意の「AIによる判定補助機能」を有効にした場合に限り、利用者自身が設定した外部AIサービス(Gemini・ChatGPT・Claude等)のAPIへデータが送信されます。利用にはGemini / OpenAI / Anthropic等のAPIキー、またはVertex AI環境が必要です。
一方で、AIを無効にすると検出できなくなる項目があります。L1-09(空白・ゼロの区別)はAI有効時のみ動作し、無効時はスキップされます。L2-02の「H28」「R3」といった和暦略称や文脈依存の省略、L2-04の「男」「男性」「M」のような意味的な表記ゆれも同様です。
精度を取るか、ローカル完結を取るかという選択がツールに組み込まれています。社内の機微データを点検する目的なら、AI補完をOFFのまま使い、検出漏れがある前提で運用するのが現実的です。
なお公式は、「Harunobuの判定ロジックはルールそのものではない」「各ルールの配点や判定ロジックはサンプル実装として独自に開発されたものであり、政府の公式見解を示すものではない」とも明記しています。スコアは絶対評価ではなく、あくまで実装例の出力です。
よくある質問
- Harunobuに読み込ませた社内データは外部に送信されますか。
-
既定では送信されません。ローカル環境で動作します。ただし任意の「AIによる判定補助機能」を有効にした場合のみ、利用者自身が設定した外部AIサービス(Gemini・ChatGPT・Claude等)のAPIへデータが送信されます。
- Harunobuを使うには何が必要ですか。
-
Windows・macOS・LinuxのいずれかとPython 3.10以上、メモリ1GB以上です。パッケージマネージャ `uv` を使った導入手順と、Dockerで起動する手順がGitHubのREADMEに記載されています。
- スコアが低いとAIに読ませられないということですか。
-
違います。Harunobuの基準は行政データ向けで、タイトル行や出典注釈があるだけでも減点されます。社内Excelでは点数そのものより、違反箇所の一覧を見て該当する問題だけを直す使い方が現実的です。
まとめ
デジタル庁の判定ツール「Harunobu」は、Excel・CSVの機械可読性を30ルール・100点満点で採点します。FATALに分類された8ルールは1つの違反で強制0点になり、1シートに複数の表、項目名の省略といった日本の社内Excelで一般的な書き方が該当します。
一方で、判定基準は行政データ向けです。表の上のタイトル行は違反扱いになり、4つのルールは最初から判定していません。AI補完をONにすれば検出範囲は広がりますが、ローカル完結という最大の利点を手放すことになります。
社内データをAIに読ませる準備としては、スコアを上げに行くのではなく、違反箇所一覧からL1の該当項目だけを拾って直すのが現実的です。セル結合、1セル複数データ、書式による意味づけ、非表示行——この4つを潰すだけでも、AIがExcelを読み違える確率は下がります。表計算データをAIに扱わせる動きは「Sheets canvas提供開始|表計算をミニアプリ化する条件」、デジタル庁の取り組みは「社内AI研修は機能で区切らない|デジタル庁の3段階」でも取り上げています。
自社のExcelやCSVをAIに読ませる前に何から整えるべきか、どこまでを自動化できるかを整理したいという方は、AI導入相談フォームからお気軽にご相談ください。
出典・参考資料
- デジタル庁: 機械可読性ルール判定ツール『Harunobu』
- デジタル庁: 行政データにおける機械可読性に関するルールをコード化する取組み
- デジタル庁: machine_readability_rule リポジトリ README (ツールの機能・動作環境・ライセンスの出典)
- デジタル庁: 既知の制限事項(limitations.md) (判定対象外ルール・誤検知/見逃しの出典)
- デジタル庁: ルール配点表(rule_scoring_table.csv) (重大度と強制0点の出典)
- デジタル庁: 機械可読性ルール(machine-readability-rules.csv) (30ルールの名称・本文の出典)
- 内閣官房: 行政データにおける機械可読性に関するルール (ルール正本)