AI利用料が月単位で増え続けている企業にとって、値下げを待つのは打ち手になりません。Spotifyが2026年9月3日に公開したClaude Code用プラグイン「shunt」は、AIコーディングの作業のうち「大量のファイルを読む」部分だけを安価なモデルへ振り分け、その工程のトークン消費を平均約90%削減したと報告しています。重要なのは90%という数字そのものではなく、同じ仕事の中で工程ごとにモデルを使い分けるという設計です。この記事では、その90%がどこの90%なのかを切り分け、自社でAI利用コストを見直すときに確認すべき4点を整理します。
Spotifyが公開した「shunt」は何をしているのか
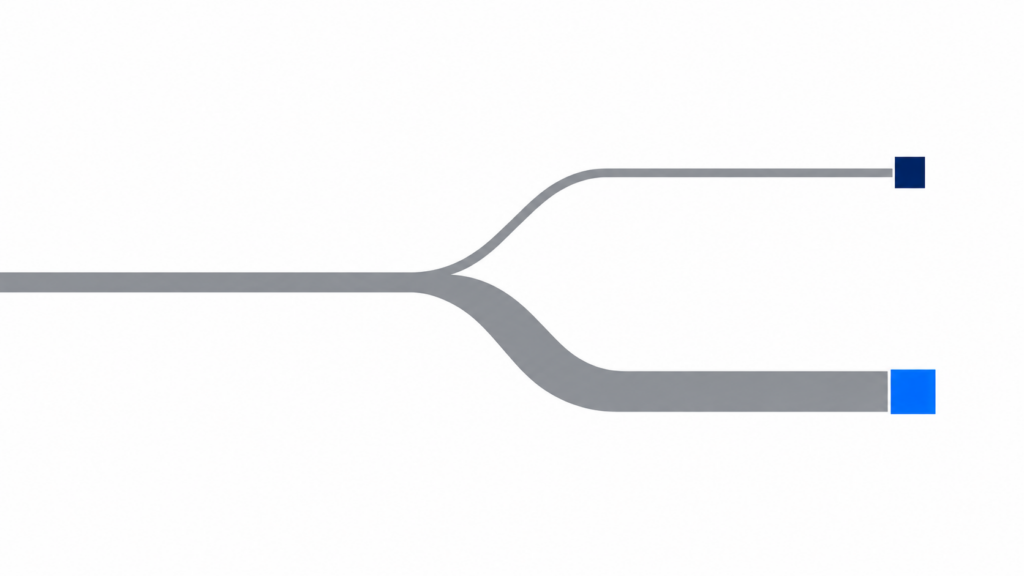
shuntは、AIコーディングツールの作業のうち入出力が中心の工程を、フロンティアモデルから安価なワーカーモデルへ自動的に逃がすプラグインです。判断や推論はフロンティアモデルに残し、「読む」「写す」だけを外に出します。
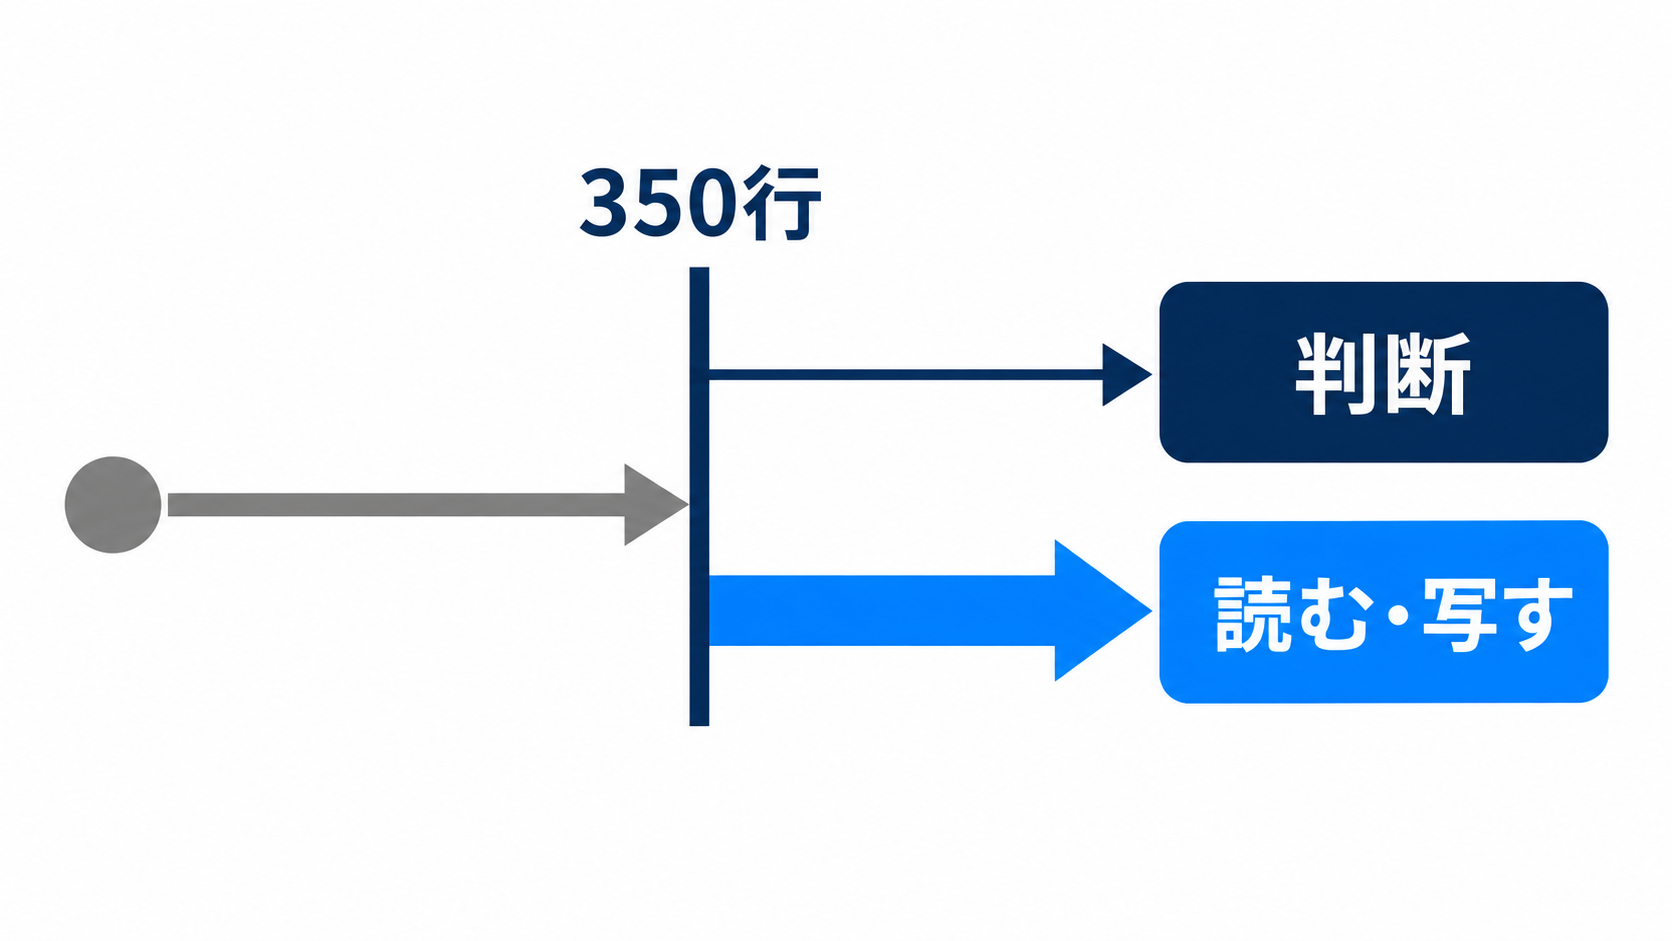
Spotify Engineeringの公開記事(著者:Dimitri Mazmanov氏/Principal Product Manager)によると、shuntは3層で動きます。
| 層 | 役割 | 具体的な動き |
|---|---|---|
| フック | 入口で遮断する | ファイル読み込みが既定350行を超えると、その読み込みをブロックしてbulk-reader側へ誘導する |
| スクリプト | 呼び出しをラップする | `bulk-read` と `code-write` がPortal CLIの呼び出しを包み、ファイル境界を明示してワーカーモデルへ送る |
| スキル | 呼び出し条件を教える | Markdownファイルが「いつ・どう呼び出すか」をAI側に指示する |
ワーカーモデルにはGemini 2.5 Flashが使われています。複数ファイルを読んで1つの問いに答える「bulk-reader」モードは temperature 0.2 で散文を使わない箇条書き出力に固定され、テストや設定ファイルなどの定型コードを生成する「code-writer」モードはコードのみを返します。プラグイン側を変更せずにワーカーモデルを差し替えられる設計になっており、振り分けの判断とワーカーの実装が切り離されています。
なお、shuntはGitHubのspotify/portal-ai-pluginsでApache 2.0ライセンスで公開されていますが、I/O中心の作業をPortal CLIのアクションレジストリ経由でワーカーモデルへ回す構造のため、Portal CLIの利用と認証が前提です。自社にそのまま持ち込めるコードではなく、設計の参考と捉えるのが実務的です。
「90%削減」はどこの90%なのか
Spotifyが報告した約90%は、複数ファイル読み込み(bulk-read)工程におけるフロンティアモデルのトークン削減率の平均です。請求総額が90%減るという数字ではありません。
原文の表現は「Mean bulk-read savings were around a whopping 90%.」で、Javaモノレポに対する4つのシナリオを測定した平均値とされています。経営判断の材料にする際は、次の3点を区別しておく必要があります。
- シナリオ別の内訳は公開されていません。 4シナリオの平均が約90%であり、どのシナリオでどれだけ削減できたかは記事に記載がありません。自社で同じ比率が出る保証はありません。
- code-write(定型コード生成)側の削減は定量化されていません。 Spotifyは「生成されたコードがAI側のコンテキストを通らないため定量化が難しい」としています。つまり公表されている数字は2モードのうち片方だけです。
- ワーカーモデル側の課金が差し引かれているかは記載がありません。 削減されたのはフロンティアモデルのトークンであり、安価なワーカーモデルには別途課金が発生します。純額での削減幅は自社で検算する必要があります。
この「工程単位の削減率」と「請求総額の削減率」を混同すると、実際の請求を見て想定とのズレに驚くことになります。単価の下落が請求額の下落に直結しない構造については、出力単価4割減でも請求は4割減らない|Fugu Max検算でも同じ論点を扱っています。
Gartnerも同じ方向の対策を挙げている
shuntの設計は単発の工夫ではなく、調査会社が推奨する方向の実装例にあたります。Gartnerは2026年6月24日、2028年までにAIコーディングのコストが開発者の平均給与を上回ると予測しました。
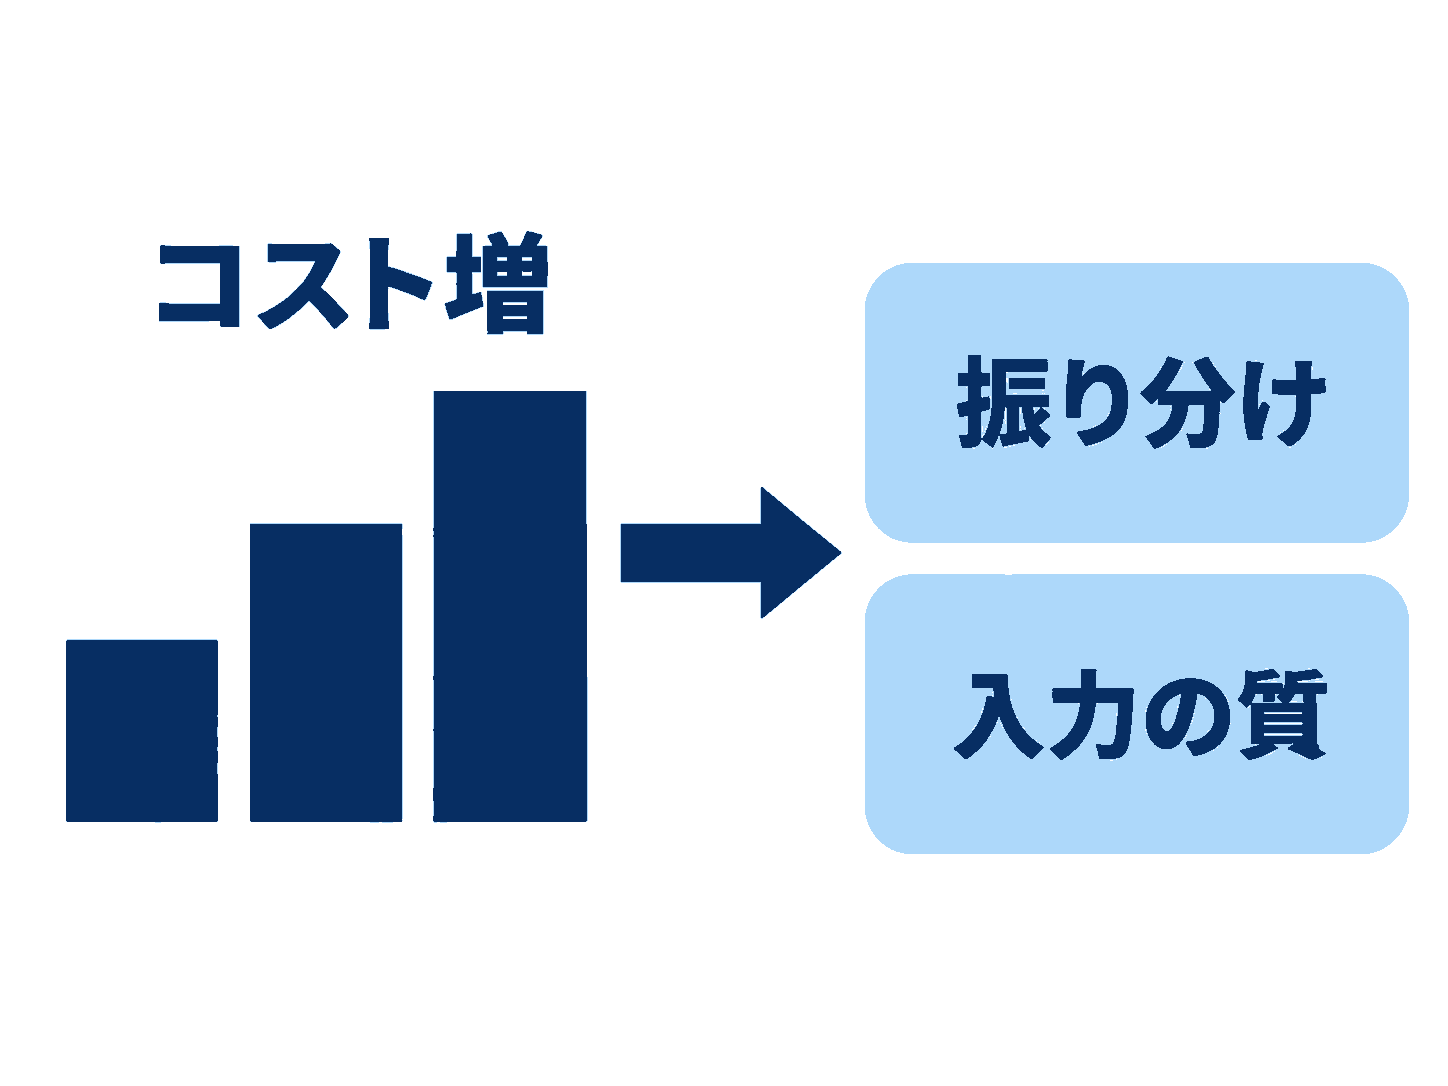
Gartnerがこの予測の要因として挙げているのは、トークン消費の増加と、席課金から従量課金へのライセンス形態の移行です。そしてGartnerのsenior principal analystであるNitish Tyagi氏は、対策としてモデルルーティング(簡単なタスクは小さいモデルへ回し、難しい仕事にフロンティアモデルを残す)とコンテキストエンジニアリング(入力の質を上げる)を挙げています。shuntがやっているのは、まさにこのモデルルーティングを開発ツールの中に自動で組み込むことです。
同時にTyagi氏は「トークン消費の増加と生産性向上の間に直接の関係はない」とも述べています。使った量が成果に比例しないのであれば、工程ごとにどのモデルを当てるかという設計が、そのまま費用対効果を左右することになります。この「切り分け」の考え方は、MAI-Cyber-1-Flashが示す|AIコスト半減は「9対1の切り分け」で作るでも整理しています。推論コストの見通しそのものについてはAI推論コストが2028年に5倍|エージェント導入の費用設計もあわせて参照してください。
なお、現場のコスト感としてSpotifyの記事は「エンジニアリングリーダーの4分の1が開発者1人あたり月200〜500ドルをトークンに費やし、一部は2,000ドルを大きく超える」と引用しています。
委譲してはいけない仕事がはっきりしている
shuntの記事で経営判断に最も効くのは、削減率ではなく「委譲してはいけない仕事」が明記されている点です。安いモデルに任せる範囲を誤ると、コストではなく品質を失います。
| 委譲しない対象 | 理由(公開記事に明記) |
|---|---|
| ファイルの編集 | ワーカーモデルの要約は行番号を信頼できる形で返せないため、正確な編集ができない |
| 推論・判断 | 表層的なパターン照合になり、スレッドセーフ性の不具合のような微妙な問題を見落とす |
| 小さな処理 | 往復に10〜30秒かかるため、小規模な委譲は時間面で逆効果になる |
この3点は、そのまま自社の線引きの雛形になります。「読む・写す」は安いモデルへ、「直す・決める」は高いモデルに残す。そして往復の待ち時間に見合う量だけを委譲する、という設計です。
経営・DX担当者が自社でまず見る4点
AI利用コストの見直しは、ツールの乗り換えではなく工程の棚卸しから始めます。shuntの設計から読み取れる確認点は次の4つです。
- 工程別のトークン内訳を出す。 何にいくら使っているかが分からないままモデルを替えても、削減幅は測れません。まず「読み込み」「生成」「推論・判断」の比率を把握します。
- 安い工程の候補を決める。 大量の文書を読んで要点を出す作業、定型フォーマットの生成作業は、判断を含まないため委譲候補になります。
- 品質ゲートを先に決める。 委譲した結果を誰が・何を基準に確認するかを決めてから切り替えます。shuntが編集と推論を委譲しないのは、このゲートを機械的に引いた結果です。
- ワーカー側の課金を含めた純額で評価する。 フロンティアモデルの削減額から、安価なモデルの利用料と運用工数を引いた金額が実際の効果です。
モデルの使い分けを外部サービスで一元管理する選択肢については、StripeがOpenRouter買収|AIコスト見直しの4視点も判断材料になります。
具体的な活用シーン
開発現場に限らず、「読む量が多く、判断が少ない」業務には同じ構造が当てはまります。
- 社内文書の一括要約(管理部門):契約書や報告書を複数まとめて読み、論点だけを抽出する工程を安価なモデルに任せ、判断と文書化は上位モデルや人が担う。
- 定型コード・設定ファイルの生成(情報システム部門):テストコードや設定ファイルのような、既存パターンに合わせるだけの生成を安価なモデルへ回す。
- 議事録の下処理(全部門):長い文字起こしから発言の整理と論点抽出までを安価なモデルで行い、意思決定事項の確定は人が行う。文字起こし自体の選び方は議事録の時間を半分に|文字起こしAIの選び方と限界で整理しています。
よくある質問
- Spotifyが報告した90%削減は、自社でも同じように出ますか。
-
同じ比率が出る保証はありません。90%はJavaモノレポ4シナリオにおける複数ファイル読み込み工程の平均値で、シナリオ別の内訳は公開されていません。自社の工程比率に当てはめて検算する必要があります。
- shuntを自社でそのまま使えますか。
-
そのままの導入は難しいです。Apache 2.0で公開されていますが、I/O中心の作業をPortal CLIのアクションレジストリ経由で処理する構造のため、Portal CLIの利用と認証が前提になります。設計の参考として扱うのが現実的です。
- 安いモデルにすべて任せてはいけない理由は何ですか。
-
Spotifyは編集と推論を委譲対象外としています。ワーカーモデルの要約は行番号を信頼できる形で返せず、スレッドセーフ性のような微妙な不具合も見落とすためです。判断を伴う工程は上位モデルに残す前提で設計します。
まとめ
Spotifyの「shunt」が示したのは、AI利用コストは値下げを待たずに工程の振り分けで下げられるということです。ただし公表された約90%は複数ファイル読み込み工程の平均であり、請求総額の削減率ではありません。定型コード生成側は未定量で、ワーカーモデル側の課金も別途発生します。
一方で、Gartnerが2028年にAIコーディングコストが開発者の平均給与を超えると予測し、その対策としてモデルルーティングを挙げていることを踏まえると、この方向性自体は一過性の工夫ではありません。「トークン消費の増加と生産性向上に直接の関係はない」という指摘も、工程設計の重要性を裏付けています。
次に取るべきアクションは、ツールの比較ではなく自社のAI利用コストを工程別に分解することです。読み込み・生成・推論の比率が見えれば、どこを安いモデルへ逃がせるか、品質ゲートをどこに置くかが具体的に決まります。
自社のAI利用コストの内訳が把握できていない、どの工程を安いモデルに任せられるか判断しづらいという方は、AI導入相談フォームからお気軽にご相談ください。工程別の棚卸しからご一緒に整理します。
出典・参考資料
- Spotify Engineering: Portal by Spotify cut my Claude Code token usage by 90% ()
- Portal by Spotify: Portal by Spotify cut my Claude Code token usage by 90% () (公式ブログのミラー)
- GitHub: spotify/portal-ai-plugins (Apache 2.0ライセンス)
- Gartner: Gartner Predicts AI Coding Costs Will Surpass Average Developer’s Salary by 2028 as Token Consumption Surges ()
- The Register: AI coding agents could soon cost more than the developers using them () (Gartnerアナリストの推奨策・コメントの出典)