公開運用されているバイブコーディング製Webアプリ200件を監査した研究で、91.0%に少なくとも1件の脆弱性が見つかりました。ただし経営判断に効くのは、この割合ではありません。同じ研究の実験では、より強いAIモデルに替えても脆弱性の再発率はほぼ下がらず(−0.5ポイント)、詳細で専門的な技術指示を足すとむしろ20.0ポイント悪化しました。効果が大きかったのは「本番運用に耐えるものを」という一言と、検査工程そのものの付与です。この記事では、AIにコードを書かせる体制で何を残すべきかを、研究の数字から整理します。
「9割に脆弱性」は何を調べた数字か
この91.0%は、AIが書いたコード全般の数字ではありません。OSSとして公開され、かつ実際に公開運用されていたバイブコーディング製Webアプリから無作為抽出した200件についての割合です。数字を自社に当てはめる前に、分母を確認する必要があります。
論文は「Understanding the (In)Security of Vibe-Coded Applications」(arXiv:2606.23130)で、著者はJunquan Deng(独立研究者)、Zhiyu Fan(Microsoft)、Ruijie Meng(シンガポール国立大学)の3名です。2026年6月22日に初版が公開され、2026年9月14日にv4へ改訂されています。国内では2026年10月7日に報じられました。
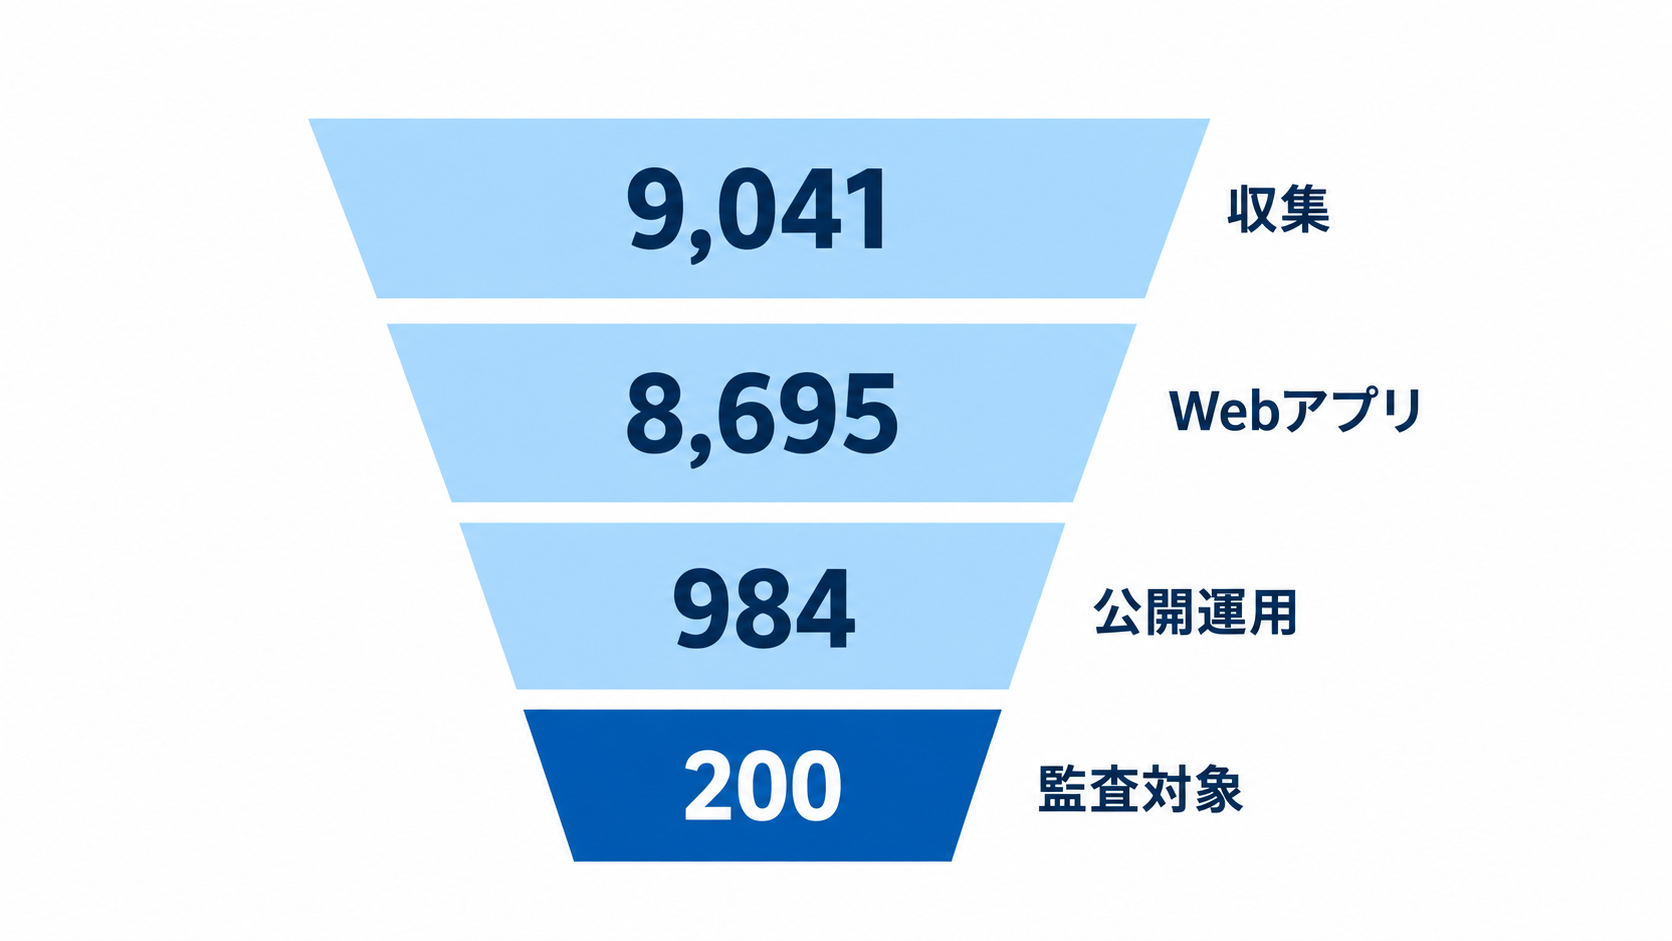
対象の絞り込みは次のとおりです。
| 段階 | 件数 |
|---|---|
| Claude CodeとLovableで作られたOSSアプリを収集 | 9,041件 |
| うちWebアプリ | 8,695件 |
| うち公開運用されていたもの | 984件 |
| 無作為抽出して監査した対象 | 200件 |
監査の作りも確認しておく価値があります。研究チームは1リポジトリあたり4本の独立した監査レポートを生成する2×2設計(エージェント2種 × 監査パイプライン2種)を採り、合計800本のレポートから11,150件の生の脆弱性報告を得ました。そこから重複を排除し、悪用可能性を評価したうえで、2名のセキュリティ専門家が独立にレビューし、両者が悪用可能と判定したものだけを採用しています(評価者間一致はCohen’s κ=0.87)。最終的に確定した脆弱性は1,186件でした。
自動スキャナの検出数をそのまま並べた調査ではない、という点はこの研究の信頼性を支えています。一方で、対象はClaude CodeとLovableの2ツールに限られ、企業内の非公開アプリは含まれません。自社の内製コードがそのまま91.0%に当てはまるとは言えません。
脆弱性はどこに集まっていたか
確認された1,186件の脆弱性のうち65.77%が、深刻度CriticalまたはHighに分類されました。種別はアクセス制御の不備、インジェクション、認証の不備の3つに集中しています。
この3種別は、第三者による不正アクセス、システムの乗っ取り、データ漏えいに直結する類型です。言い換えると、見つかった問題の大半は「動作はするが、権限のない人も触れてしまう」タイプでした。画面上の挙動を確認するだけの検収では発見できません。
公開しているサイトがAIエージェントから探索を受ける実態は「AIエージェントが公開サイトを試した|点検する7項目」でも扱っています。
原因の63.4%は「気づいていない」こと
論文は脆弱性の原因を3つの系統的な限界に分類しました。最も大きいのは知識の欠如で63.4%、次いで目的の偏りが23.1%、記憶の欠落が13.5%です。
| 原因 | 割合 | 内容 |
|---|---|---|
| 知識の欠如(knowledge defects) | 63.4% | AIエージェントも利用者も、そのアプリに必要なセキュリティ要件を認識できていない |
| 目的の偏り(objective defects) | 23.1% | 目の前の機能を動かすことが、長期的な正しさ・安全性より優先される |
| 記憶の欠落(memory defects) | 13.5% | 開発の初期に決めたセキュリティ上の約束が、プロジェクトの進行とともに保持・伝播されない |
最大の原因が「知識の欠如」である点には実務的な意味があります。AIの出力品質の問題ではなく、発注側も開発側も必要な要件に気づいていないという構図だからです。要件に気づいていない人がレビューしても、同じ見落としが通過します。
論文はさらに、8つの再発パターンを挙げています。変更の伝播漏れ、未完了のまま放置された宿題、デモを成立させることを優先した設計、不具合修正の副作用(見えているエラーを消すためにセキュリティ制御を弱める)、危険な指示そのもの、ハルシネーション、暗黙のセキュリティ要件の違反、利用者任せの設定です。このうち「不具合修正の副作用」と「利用者任せの設定」は、開発の速さを優先する現場で起きやすい類型です。
強いモデルに替えても減らない|効いた対策と悪化した対策
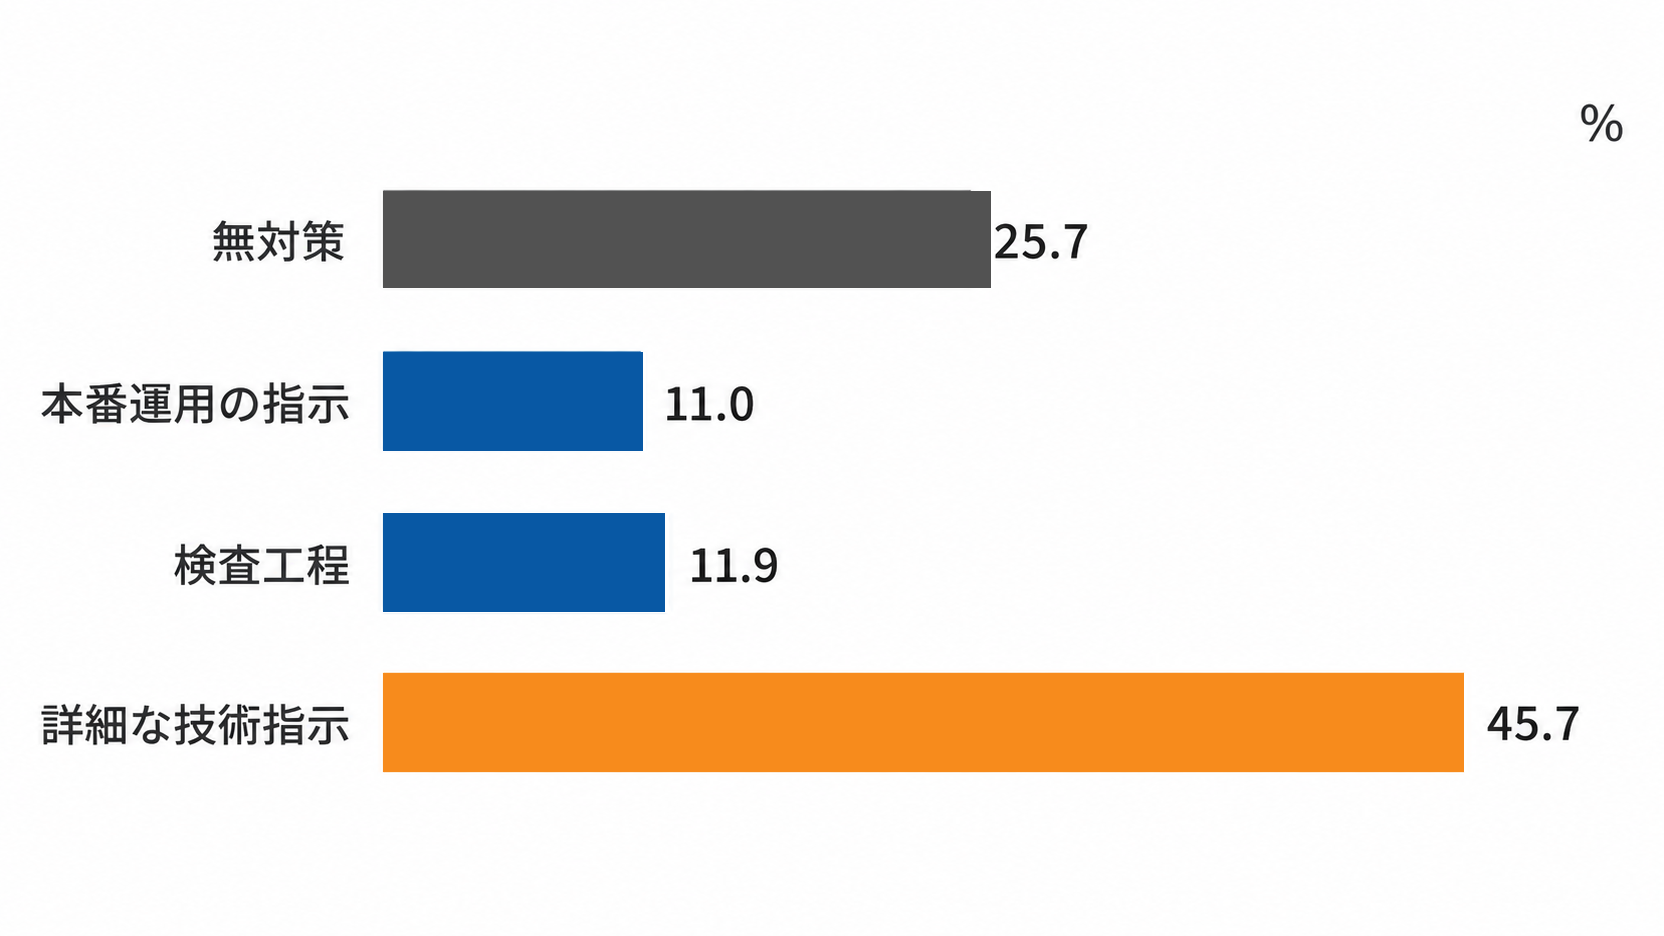
研究チームは1,680回の実行で、条件を変えると脆弱性の再発率がどう変わるかを測りました。結果は直感に反します。モデルを強くしてもほとんど下がらず、詳細で専門的な技術指示を足すと悪化します。
| 条件 | 再発率 | ベースラインとの差 |
|---|---|---|
| 無対策(ベースライン) | 25.7% | — |
| 「本番運用に耐えるものを」と指示する | 11.0% | −14.8ポイント |
| セキュリティ検査の仕組みを工程に組み込む | 11.9% | −13.8ポイント |
| 「丁寧に仕上げて」と指示する | 約22.8% | −2.9ポイント |
| 自己点検を依頼する | 約23.8% | −1.9ポイント |
| より強いモデルに替える | 約25.2% | −0.5ポイント |
| より弱いモデルに替える | 約39.5% | +13.8ポイント |
| 詳細・専門的な技術指示を与える | 45.7% | +20.0ポイント |
読み取れることは3つあります。
- モデルの強さは解決策にならない。より強いモデルへの変更は−0.5ポイントで、誤差の範囲です。一方、より弱いモデルに落とすと+13.8ポイント悪化します。つまりモデル選定は「下げない」ためには効きますが、「上げる」ことでは解決しません。
- 詳細な技術指示は逆効果になりうる。+20.0ポイントという悪化幅は、この実験で最大です。実装方法を細かく指定するほどAIはその指示の実現に最適化し、指示に書かれていない安全要件が落ちると解釈できます。前章の「目的の偏り」23.1%と整合する結果です。
- 効いたのは「本番運用に耐えるものを」の一言と、検査工程の付与。前者で−14.8ポイント、後者で−13.8ポイントです。どちらも実装方法を指定していません。求める品質水準を宣言するか、確認の工程を増やすかのどちらかです。
ただし論文は、どの条件でも脆弱性は残ったと明記しています。ハーネスの改善やプロンプト戦略は発生率を下げられるが、根底にあるセキュリティリスクは取り除けない、というのが結論です。
AIを使った開発で成果が割れる条件は「AIで開発しても3割は生産性が下がる|差を生む4条件」でも整理しています。
発注・内製の判断にどう落とすか
この研究が経営判断に与える示唆は「AIで作るのをやめる」ではありません。検査工程を誰が持つかを、契約と体制で先に決めることです。確認すべきは次の4点です。
- 検収の方法を「動くか」から変える:見つかった脆弱性の中心はアクセス制御・認証の不備です。画面操作で動作確認するだけの検収では通過します。権限のないアカウントで触れるかを試す手順を、検収項目に加えます。
- 指示の出し方を実装から品質水準へ移す:詳細な技術指示が+20.0ポイント、品質水準の宣言が−14.8ポイントという結果は、発注書の書き方にそのまま効きます。実装方法を細かく指定するより、「本番運用に耐えること」を明示するほうが安全側に働きます。
- 検査工程を人かツールかで明示する:検査の仕組みを組み込むと−13.8ポイントでした。ただし残存率は11.9%です。自動化した検査は「減らす」ものであって「ゼロにする」ものではない前提で、人のレビューをどこに置くかを決めます。
- 外注先がAIで書く場合の取り決めを確認する:AI生成コードの利用可否、脆弱性が見つかった場合の責任分界、検査レポートの提出義務。契約書に書かれていなければ、発生時に揉めます。
AI導入の進め方全体は「AI導入支援|中小企業の進め方と支援会社の選び方」、発注前に確認する具体的な基準は「AI導入支援会社の選び方|発注前に確認する7つの基準」で解説しています。
具体的な活用シーン
AIにコードを書かせること自体は否定されていません。リスクの出方が用途で変わります。
- 社内限定のツールを内製する:社外から到達できないネットワークに閉じているなら、アクセス制御の不備が直ちに事故にならない場合があります。ただし社内不正と、将来の公開転用には備えが必要です。
- 外注先がAIで開発する:発注側が検査工程を持たないと、見落としはそのまま納品物に残ります。検収項目と責任分界を契約に落とすことが前提になります。
- PoCを本番へ転用する:最も危険な経路です。論文の8パターンには「デモ志向の設計」と「未完了のまま放置された宿題」が含まれます。PoCは動かすことが目的なので、この2つが構造的に発生します。PoCから本番へ移す判断の設計は「PoCが本番で止まる理由|決める順番と4段階の監督」で扱っています。
よくある質問
- この91.0%という数字は自社の内製コードにも当てはまりますか。
-
そのままは当てはまりません。調査対象は、OSSとして公開され公開運用されていたバイブコーディング製Webアプリから無作為抽出した200件です。企業内の非公開アプリは含まれていません。
- AIに書かせるとき、どんな指示を出せばよいですか。
-
実装方法を細かく指定するより、「本番運用に耐えること」のような品質水準の宣言が有効でした。研究では前者が再発率を20.0ポイント悪化させ、後者が14.8ポイント改善しています。
- もっと強いAIモデルを使えば解決しますか。
-
解決しません。より強いモデルへの変更による改善は0.5ポイントにとどまりました。一方で弱いモデルに落とすと13.8ポイント悪化します。モデル選定は下限を守るための条件であり、対策ではありません。
まとめ
公開運用されていたバイブコーディング製Webアプリ200件の監査で、91.0%に脆弱性が見つかり、確認された1,186件のうち65.77%がCriticalまたはHighでした。原因の63.4%は、AIも利用者も必要なセキュリティ要件に気づいていない「知識の欠如」です。緩和実験では、より強いモデルへの変更は−0.5ポイントとほぼ効かず、詳細な技術指示は+20.0ポイント悪化させました。効いたのは「本番運用に耐えるものを」という品質水準の宣言(−14.8ポイント)と、検査工程の付与(−13.8ポイント)です。それでも再発率は11%台が残ります。
次に取るべきアクションは、AIツールの比較ではなく検収項目の書き換えです。現在の受け入れテストに「権限のないアカウントで操作できないことの確認」が入っているかを見てください。入っていなければ、そこが今回の研究が指摘した穴と同じ場所です。内製・外注のどちらであっても、検査工程を誰が持つかを先に決めることが出発点になります。
AIを使った開発でどこに検査工程を置くべきか、外注先との責任分界をどう決めるかを整理したいという方は、AI導入相談フォームからお気軽にご相談ください。
出典・参考資料
- : Understanding the (In)Security of Vibe-Coded Applications () (arXiv:2606.23130 v4。91.0%・65.77%・1,186件・緩和実験の出典)
- : Understanding the (In)Security of Vibe-Coded Applications(HTML版本文) (監査設計・専門家2名による検証・3分類の割合・8パターンの出典)
- ITmedia NEWS: バイブコーディングで作った公開中のWebアプリ、9割に脆弱性 MSの研究者など調査 ()
- Ledge.ai: バイブコーディングで開発したWebアプリ200件を監査、91%に脆弱性 Microsoft・NUS所属研究者らが原因分析