ELYZAが2026年10月2日、国立情報学研究所のLLM-jpが国内で事前学習した基盤モデルをもとにした推論モデル2種を、商用利用できるApache 2.0ライセンスで公開しました。ただし公開された比較表を読むと、総合スコアでは海外のオープンウェイトモデルに届いていません。それでも検討に値するのは「社外にデータを出せない業務」に限った話です。この記事では、ELYZAが公開した20ベンチマークの内訳から、国産LLMを自社運用する価値がある用途と、現時点では選ばないほうがよい用途を切り分けます。
ELYZAが公開した国産LLM推論モデル2種の中身
ELYZAが2026年10月2日に公開したのは、思考過程を出力する「推論モデル」2種です。いずれもHugging FaceのモデルカードでApache 2.0ライセンスが明示され、商用利用が認められています。
| 項目 | ELYZA-Thinking-1.0-llm-jp-4-33b | ELYZA-Thinking-1.0-llm-jp-4-32b-a3b |
|---|---|---|
| 構成 | Dense(全パラメータを使用) | MoE(混合エキスパート) |
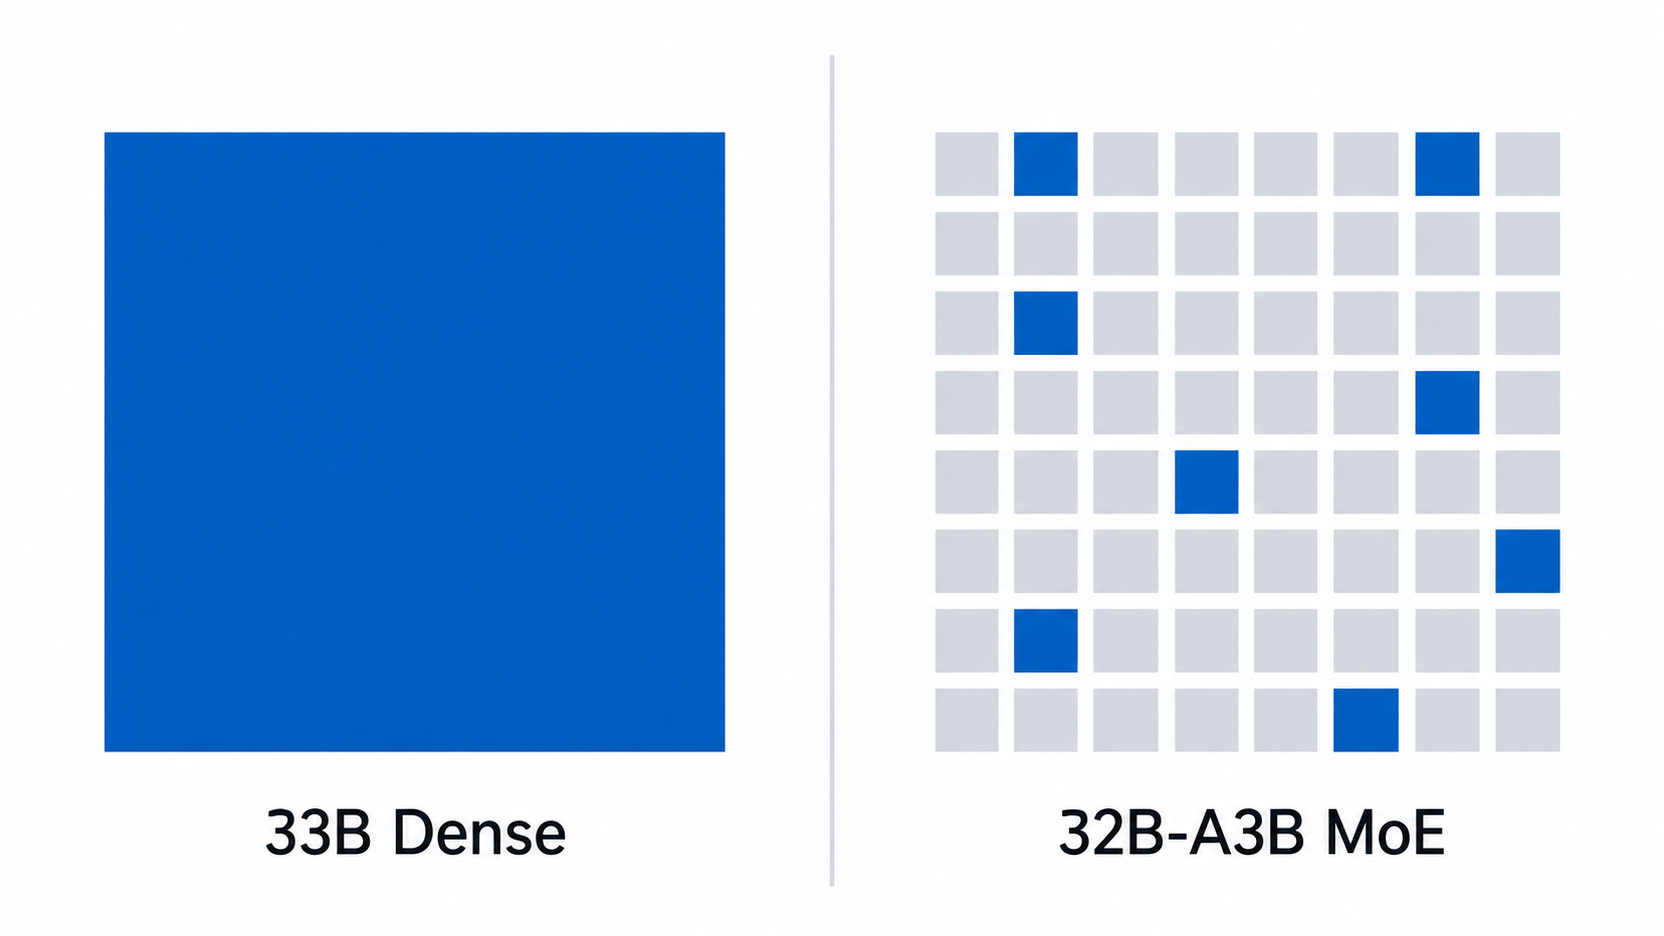
| パラメータ数 | 33B | 総計32B/1トークンあたり約3Bが稼働 |
| エキスパート構成 | — | 128エキスパートのうち8個を使用・32層 |
| コンテキスト長 | モデルカードに明記なし | 65,536トークン |
| データ型 | BF16 | BF16 |
| ライセンス | Apache 2.0 | Apache 2.0 |
| ベースモデル | llm-jp/llm-jp-4-33b-base | llm-jp/llm-jp-4-32b-a3b-base |
ベースモデルの `llm-jp-4` は、国立情報学研究所のLLM-jpが日本国内で一から事前学習した大規模言語モデルです。ELYZAはこの基盤に対して中間学習以降を担当しました。ELYZAの技術ブログによれば、学習は推論の軌跡データを中心とした中間学習(約63Bトークン)、日本語と英語の指示データによる教師ありファインチューニング(数百万ペア)、正解を機械的に検証できる問題 約10万件を使った強化学習の3段構成です。
ツール呼び出しはOpenAI互換で、`tools` フィールドで関数定義を渡すと `tool_calls` の形式で返ります。既存のOpenAI APIを前提に組んだアプリケーションからの差し替えを想定した仕様です。
なお、ELYZAは同じ2026年10月2日に、AIがAIを開発する「再帰的自己改善」を研究する組織 ELYZA RSI Research の設立も公式ニュースで発表しています。今回のモデル公開は、その前段にある要素研究という位置づけです。
総合スコアでは海外オープンウェイトモデルに届いていない
ELYZAが公開した比較表では、33bモデルの総合平均は61.69で、同じベース系統の最新版を上回る一方、海外のオープンウェイトモデル2種には及びません。「国産だから性能で勝った」という読み方は、公開データと一致しません。
ELYZAは知識・推論、数学、日本文化・知識、指示追従、翻訳、コーディング、エージェント能力の7分類・計20ベンチマークで評価しています。総合平均は次のとおりです(2026年10月時点のモデルカード記載値)。
| モデル | 総合平均 | 日本語平均 | 英語平均 |
|---|---|---|---|
| Gemma 4 31B | 70.54 | 68.88 | 73.09 |
| Qwen3.5-27B | 68.18 | 66.05 | 71.81 |
| ELYZA-Thinking-1.0-llm-jp-4-33b | 61.69 | 62.18 | 59.72 |
| llm-jp-4.1-33b-thinking(ベース系統の最新版) | 60.64 | 61.78 | 59.11 |
| ELYZA-Thinking-1.0-llm-jp-4-32b-a3b | 58.46 | 59.61 | 55.94 |
| Qwen3-32B | 58.11 | 58.97 | 57.89 |
| llm-jp-4-33b-thinking | 51.50 | 53.04 | 48.25 |
| OLMo 3.1 32B Think | 50.71 | 49.88 | 53.49 |
ELYZA自身も技術ブログで、英語性能が日本語性能に比べて劣ること、知識・推論と数学については直近の上位モデルに対して改善の余地があることを明記しています。公開側が限界を書いている点は、評価する側にとっては扱いやすい材料です。
数字の開きが大きいのは推論の難度が高い領域です。多言語の数学問題 PolyMath(日本語)はELYZAの33bが35.90に対しQwen3.5-27BとGemma 4 31Bがいずれも66.70、米国の数学競技 AIME 2024+2025 は68.85に対しQwen3.5-27Bが93.33、大学院レベルの科学知識 GPQA-Diamond は69.95に対しGemma 4 31Bが86.65でした。
勝ち負けの内訳を業務タスクに翻訳する
20ベンチマークの内訳を見ると、ELYZAの33bが優位に立つのは日本語の文書理解と日本語の指示追従に限られます。この偏りは、検討してよい業務と見送るべき業務の線引きにそのまま使えます。
比較表のうち、ELYZAの33bが掲載モデル中で首位だった項目は2つです。日本語の複数文書をまたいで答えを組み立てる JEMHopQA が73.85(次位はGemma 4 31Bの63.91)、日本語で細かい制約条件を守らせる JFBench が39.02(次位はQwen3.5-27Bの34.12)でした。日本語の知識を問う JamC-QA も66.35で、ベース系統の最新版 llm-jp-4.1-33b-thinking(57.69)とQwen3.5-27B(59.77)を上回っています。
この内訳を業務タスクに置き換えると、次のように整理できます。
| ベンチマークが測っている力 | 対応する業務タスク | ELYZA 33bの立ち位置 | 判断 |
|---|---|---|---|
| 日本語マルチホップQA(JEMHopQA 73.85) | 社内規程・マニュアル横断の日本語Q&A | 比較表で首位 | 検討に値する |
| 日本語の指示追従(JFBench 39.02 / M-IFEval-ja 85.84) | 書式・文字数・禁止表現を守らせた文書生成 | 首位または上位 | 検討に値する |
| 日本語知識(JamC-QA 66.35) | 国内制度・商習慣を前提にした応答 | 上位(首位はGemma 4 31Bの69.64) | 検討に値する |
| コーディング(JHumanEval 95.73) | 定型スクリプトの生成 | 上位(首位はGemma 4 31Bの98.78) | 用途次第 |
| 難問の数学・科学推論(PolyMath 35.90 / AIME 68.85 / GPQA-Diamond 69.95) | 数値計算を伴う分析、技術的な難問の検討 | 大差で劣位 | 現時点では選ばない |
| ツール呼び出し(BFCL v4 38.73 / Nejumi BFCL 46.53) | 外部システムを自律的に操作するAIエージェント | 大差で劣位(BFCL v4はQwen3.5-27Bが69.37) | 現時点では選ばない |
実務上いちばん効くのは最後の行です。ツール呼び出しの精度は、AIエージェントが「どの機能をどの引数で呼ぶか」を外さない能力に直結します。ELYZAの33bはBFCL v4で38.73と、Qwen3.5-27Bの69.37に大きく離されています。社内文書を読ませて日本語で答えさせる用途は候補になりますが、業務システムを自律的に操作させる用途を今回のモデルで組むのは時期が早いと判断できます。
AIエージェントに権限を渡す前の確認事項は「自律型AIエージェント導入のセキュリティ|権限設計と人間の承認ゲート」で整理しています。
自社で動かすかを決める4つの判断軸
国産LLMを自社運用する判断は、性能比較ではなく制約条件から入ります。次の4点を順に確認すると、検討を続けるべきかどうかが先に決まります。
1. そのデータは本当に外に出せないのか
最初に決めるのは、対象業務のデータをクラウドAPIに送れるかどうかです。ここが「送れる」なら、総合スコアで上位のクラウドモデルを使うほうが合理的です。モデル選定の軸そのものは「生成AIの選び方2026|「最強モデル探し」をやめる4つの軸」で整理しています。
送れない理由が契約・法令・顧客との取り決めのどれなのかまで分解すると、クラウド側の設定で解消できる場合もあります。OpenAIはデータを保持しない運用の適用範囲を広げており、その条件は「OpenAIがゼロデータ保持を拡大|適用条件と落とし穴」で確認できます。
2. 日本語タスクの比重が高いか
前章の表のとおり、ELYZAの2モデルが優位なのは日本語の文書理解と日本語の指示追従です。英語資料の処理や数値分析が業務の中心なら、国産である利点は数字に表れません。
3. 重みを置く場所と運用の担い手があるか
「無料公開」は「すぐ使える」とは別の話です。33BパラメータをBF16(1パラメータ2バイト)で保持すると、重みだけで概算66GBになります。32b-a3bも総パラメータは32Bなので重みの総量は概算64GBで、メモリに載せる量はDense版とほぼ変わりません。MoEの利点は生成1トークンあたりの計算量が小さいこと(約3Bぶん)であって、必要メモリが減ることではありません。
Hugging Face上には第三者が公開したGGUF形式やMLX形式の量子化版も存在しますが、いずれもELYZA公式の配布物ではなく、量子化による品質低下の度合いは検証が必要です。
4. ライセンスを社内で読み切れるか
Apache 2.0は商用利用・改変・再配布を認める寛容なライセンスですが、著作権表示とライセンス文の保持、変更点の明示といった条件があります。モデルを組み込んだ製品を顧客に納品する場合は、法務部門の確認を経路に入れておくほうが安全です。自社利用のみであれば確認事項は少なくなります。
具体的な活用シーン
国産LLMの自社運用が成り立つのは、「日本語の文書」と「持ち出し禁止」が重なる業務です。3つの型に整理できます。
- 社内規程・業務マニュアルの日本語Q&A:人事規程や品質マニュアルのように、社外に置けないが参照頻度が高い文書群。JEMHopQAが測る複数文書横断の読解がそのまま効く領域です。社内ナレッジ検索の設計要件は「バークレイズ1.6万人の社内ナレッジ検索AI|移植4条件」で扱っています。
- 外部送信が禁じられた記録の要約・分類:検査記録、顧客との折衝メモ、医療・金融など規制業種の業務記録。要約と分類は指示追従の精度が効くため、M-IFEval-ja 85.84という水準が判断材料になります。
- クラウドAPIとの併用(機密は自社・それ以外は外部):全業務を自社運用に寄せる必要はありません。機密度で振り分ける前提に立つと、国産モデルの総合スコアが上位でないことは障害になりません。業種特化・専有型のAI基盤という考え方は「富士通が金融機関向けAI基盤を開発|専有型・業種特化AIの読み解き方」でも整理しています。
高機能モデルを追わず自社の制約に合わせた構成を選んだ事例としては「ディップが高機能AIを捨てた理由|社内AI活用の分岐点」も参考になります。
よくある質問
- Apache 2.0ライセンスなら、自社製品に組み込んで販売してもよいのですか。
-
Apache 2.0は商用利用・改変・再配布を認めています。ただし著作権表示とライセンス文の保持、変更点の明示が条件です。顧客への納品を伴う場合は法務確認を経路に入れてください。
- 33bと32b-a3bはどちらを選ぶべきですか。
-
精度を優先するなら総合平均61.69の33b、生成速度を優先するなら1トークンあたり約3Bしか稼働しない32b-a3bです。必要メモリは重み概算で66GB対64GBとほぼ同等で、MoE版でも軽くはなりません。
- クラウドのAIサービスから乗り換えるべきですか。
-
データをクラウドに送れる業務であれば、乗り換える根拠はありません。公開ベンチマークの総合平均では海外モデルが上位です。検討対象は「社外に出せない日本語文書」を扱う業務に限られます。
まとめ
ELYZAが2026年10月2日に公開した国産LLM推論モデル2種は、Apache 2.0で商用利用でき、日本語のマルチホップQA(JEMHopQA 73.85)と日本語の指示追従(JFBench 39.02)では比較表の首位に立ちました。一方で総合平均61.69はGemma 4 31Bの70.54・Qwen3.5-27Bの68.18に届かず、ツール呼び出し(BFCL v4 38.73)と数学的推論(PolyMath 35.90)では差が大きく開いています。
選ぶ理由は性能ではなく制約条件です。次に取るべきアクションは、モデルの比較ではなく「社外に出せないデータの棚卸し」です。対象業務の文書が本当に持ち出し禁止なのか、禁止の根拠が契約・法令・取り決めのどれなのかを一覧にするだけで、自社運用を検討する必要があるかどうかが決まります。棚卸しの結果が「出せる」なら、クラウドモデルを使うほうが早く成果が出ます。
自社のどのデータが持ち出し禁止で、どの業務なら自社運用のLLMが見合うのかを整理したいという方は、AI導入相談フォームからお気軽にご相談ください。
出典・参考資料
- Hugging Face(ELYZA, Inc.): elyza/ELYZA-Thinking-1.0-llm-jp-4-33b (公式モデルカード。ライセンス・比較表20項目の出典)
- Hugging Face(ELYZA, Inc.): elyza/ELYZA-Thinking-1.0-llm-jp-4-32b-a3b (MoE構成・コンテキスト長65,536の出典)
- ELYZA: 『ELYZA-Thinking-1.0-llm-jp-4』シリーズの学習方法と評価結果 () (学習3段構成・7分類20ベンチマーク・限界の記述)
- ELYZA: お知らせ (ELYZA RSI Research 設立(2026-10-02))
- ITmedia AI+: 国産AI『LLM-jp-4』ベースのAIモデル、KDDI傘下のELYZAが無料公開 ()