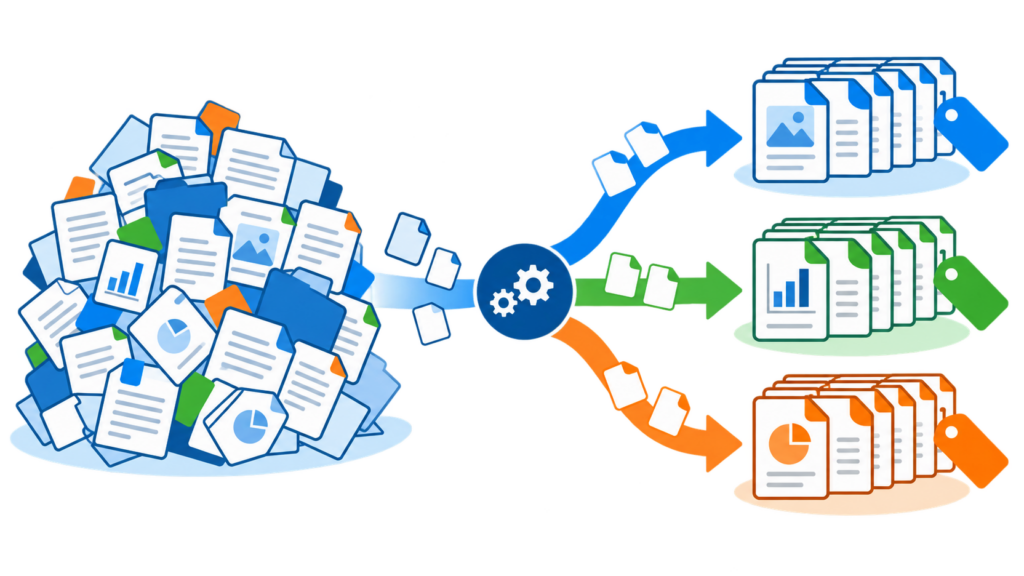
Googleは2026年8月28日、Google Drive上のファイルをGeminiが自動で分類し、データ分類ラベルを付与する機能をオープンベータとして公開しました。従来のAI分類が「ラベル選択肢ごとに100件以上の学習用ファイルを管理者が用意する」方式だったのに対し、Gemini方式は自然言語で書いた指示だけで動きます。機密情報の棚卸しに着手できない最大の理由だった準備コストが下がった一方、対象エディション・暗号化ファイルの除外・判定のゆらぎ・日本語の扱いという4つの制約が残ります。導入可否を判断するために押さえるべき事実を、Google公式の発表とヘルプの記述から整理します。
Google Driveの「Geminiベースのデータ分類」で何が始まったのか
2026年8月28日、GoogleはGoogle DriveのAI分類でGeminiモデルを使う方式を、申請制のクローズドベータからオープンベータへ移行しました。対象エディションの管理者であれば、申し込みなしで設定できます。
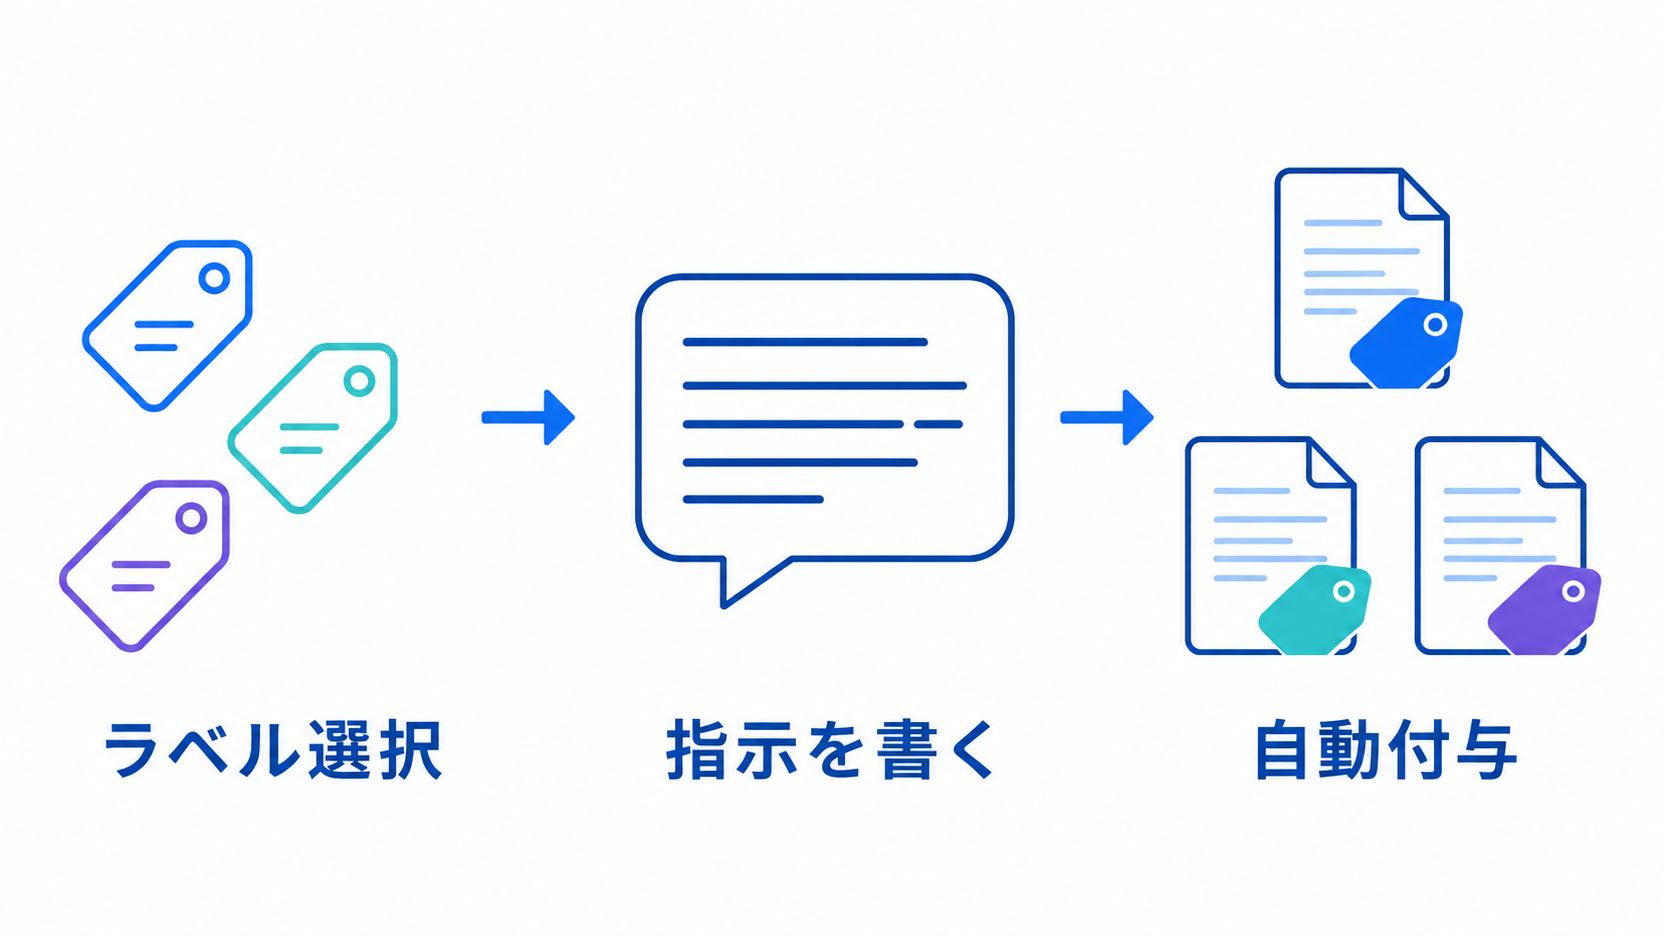
Google Workspace Updatesの発表によれば、管理者が行うのは「使うラベルの選択」「Geminiへの指示(分類の目的と方針)」「評価対象とするファイルの範囲」の3つの設定です。設定後はGeminiがファイルの内容を評価し、該当するラベルを自動で適用します。ファイルのオーナーと編集者は、付与されたラベルを確認し、必要なら修正できます。ラベルの適用履歴は監査ログに記録されます。
設定場所は管理コンソールの「セキュリティ > アクセスとデータ管理 > データ分類」です。ロールアウトはRapid Release・Scheduled Releaseの両ドメインに対して段階的に行われ、完了目標は2026年9月30日とされています。
この機能は、2025年11月11日にクローズドベータの申込受付が始まったものです。当時の対象はGoogle Workspace Enterprise Plusのみで、既存のデータ分類プログラムを持つ組織に限定されていました。
従来のAI分類と何が変わったのか
変わったのは「独自モデルを訓練するための学習データを用意する必要がなくなった」点です。ラベル選択肢あたり100件以上のファイルを管理者が探して手動でラベル付けする作業が、自然言語の指示文に置き換わりました。
Google Workspace HelpのAI分類に関するドキュメントによれば、2つの方式は次のように整理できます。
| 比較軸 | カスタムモデル方式(従来) | Geminiベースの指示方式(2026年8月〜) |
|---|---|---|
| 管理者の準備 | ラベル選択肢ごとに最低100ファイルの学習データ(上限100万ファイル) | 自然言語の指示文のみ |
| 分類の根拠 | 自組織のデータで訓練した専用の機械学習モデル | Gemini(大規模言語モデル)によるファイル内容の判定 |
| 開始までの時間 | 学習データの収集・ラベル付け・訓練が必要 | 指示を書けば開始できる |
| 再訓練 | 2週間ごとに自動で再訓練され、停止できない | 再訓練の概念なし(指示文を書き換える) |
| 言語 | ラテン文字ベースの言語のみ対応 | 公式ヘルプに明記なし(後述) |
学習データの準備は、実務では「どのファイルが機密なのかを人が判断してラベルを付ける」作業そのものです。ラベル7段階で運用するなら最低700件。この初期コストが、多くの企業でデータ分類プロジェクトが止まる地点でした。Gemini方式はここを迂回します。
なお、いずれの方式でも、社内Driveの内容と関連するプロンプトは認可されたWorkspace環境の中に分離され、Googleのモデルの学習には使われないとヘルプに明記されています。
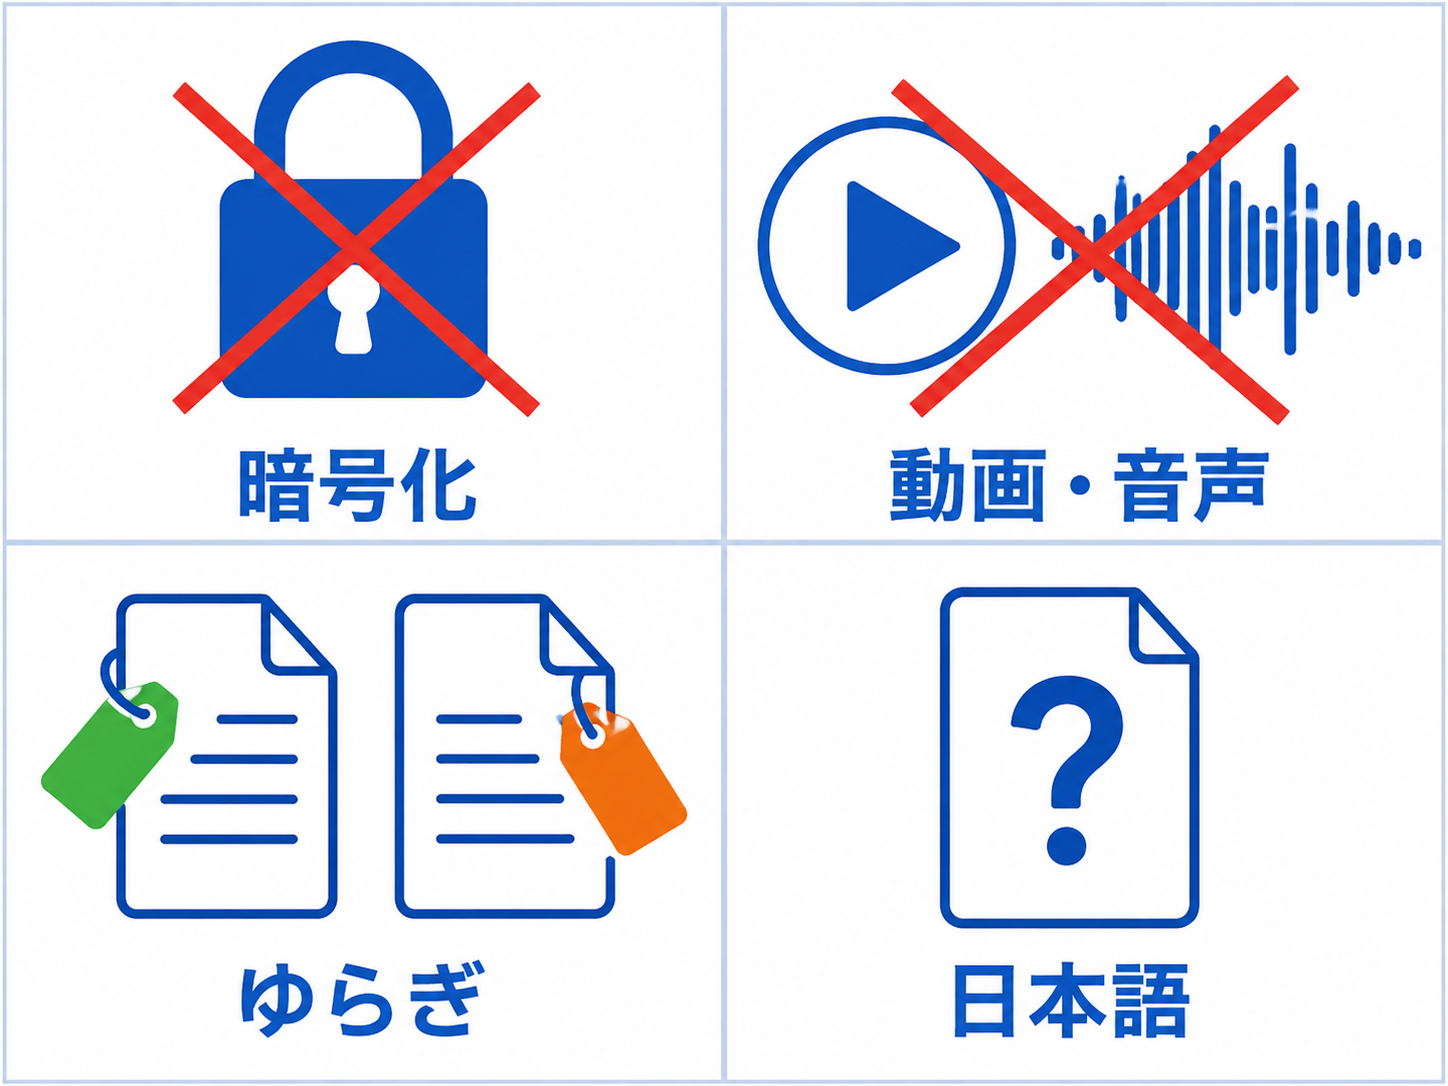
導入前に確認すべき4つの制約
「学習データ不要」は事実ですが、それだけで自社に適用できるとは限りません。公式ヘルプの記述から、導入判断を左右する制約は4つあります。
制約1:使えるエディションが限られる
利用条件はエディションで決まります。Google Workspace Updatesの発表では、対象は次のとおりです。
| 区分 | 対象 |
|---|---|
| Enterprise | Enterprise Plus |
| Education | Google AI Pro for Education |
| その他 | Frontline Plus |
Google Workspace Helpでは、これに加えて Gemini Enterprise–Legacy および AI Security アドオンでも利用できると記載されています。公式が挙げる対象エディションの一覧に、Business Standard や Business Plus は含まれていません。自社の契約エディションを先に確認する必要があります。
また、ラベルを付与される対象は「共有ドライブ上のファイル、または分類ラベルをサポートするライセンスを持つユーザーが所有するファイル」です。ライセンスが混在する組織では、対象外のユーザーが個人ドライブに持つファイルが抜け落ちます。
制約2:暗号化ファイルと動画・音声は評価されない
クライアント側暗号化(CSE)を有効にしたファイルは、Googleが復号できないため、AI分類の学習にも自動ラベル付与にも使えません。この制限はGemini方式・カスタムモデル方式の両方に等しく適用されます。最も機密性の高い文書にCSEを掛けている組織ほど、自動分類の網から外れる範囲が広くなる、という逆転が起きます。
対象となるファイルの範囲は、Drive DLPと同じ「インデックス可能なテキスト処理」に従います。画像はOCRでテキストを抽出して評価されますが、動画ファイルと音声ファイルは評価されません。会議録画や通話録音を機密として管理したい場合、この機能では扱えません。
制約3:同じファイルに違うラベルが付くことがある
Google Workspace Helpは、Gemini方式の制限として、大規模言語モデルの確率的な性質により「同一またはほぼ同一のファイルに対して、Geminiが異なるラベル選択肢を割り当てることがある」と明記しています。決定論的な分類器ではありません。
もう1点、Gemini方式では「非アクティブなファイルのスキャンを手動でオンにする必要がある」とされています。既存の古いファイルを分類対象に含めたい場合、この設定を見落とすと新規・更新ファイルしか分類されません。スキャンは1〜2週間に最低1回、加えてアップロード時と変更時に実行されます。
なお、編集者またはオーナーがラベルを修正すると、以降AI分類はその値を変更しません。人の判断が上書きとして残る設計です。
制約4:日本語ファイルの扱いが公式に明記されていない
Google Workspace Helpには「ラテン文字ベースの言語のみ対応(Only Latin character-based languages are supported)」という記述がありますが、これは「Can the model train on multiple languages?」というカスタムモデルの学習データに関する節に置かれています。Geminiベースの指示方式に同じ制限が掛かるかどうかは、2026年9月4日時点の公開ドキュメントでは確認できませんでした。
Gemini自体は日本語に対応しており、Google Workspace の Gemini 機能の言語サポート一覧には日本語が含まれます。ただし、それはデータ分類機能での日本語ファイルの判定精度を保証するものではありません。日本語の契約書や設計書を主対象に考えている場合、少量のファイルで試験運用し、実際の付与結果を確認してから範囲を広げる進め方が現実的です。
経営・DX担当者への示唆
この機能を「機密情報管理が自動化される」と読むと判断を誤ります。自動化されるのは「ラベルを貼る作業」であって、「何を機密と呼ぶかを決める作業」ではありません。
決めるべきはラベル設計であり、機能ではない
AI分類が使うラベルは、公開済みで、選択肢が最低2・最大7である必要があります。この2〜7の中身、つまり「自社では何を機密とし、誰まで見せるか」を決めるのは人の仕事です。Gemini方式が省いたのは学習ファイルの収集であり、分類基準の合意形成ではありません。指示文の品質がそのまま分類品質になるため、基準が曖昧なまま導入すると、曖昧なラベルが全社のファイルに貼られます。
AIエージェント導入の前工程として位置づける
Googleはこの機能を、エージェントが自律的に動く時代のセキュリティ強化として位置づけています。AIエージェントに社内ファイルへのアクセス権を与える構想を持つ企業にとって、「どのファイルが機密か」がメタデータとして付いているかどうかは、権限設計の前提条件です。ラベルが無ければ、エージェントに渡してよい範囲を機械的に絞れません。権限設計の考え方はAIエージェントの権限管理と3つの設計変数で整理しています。
レビューの担い手を決めてから始める
Geminiの判定にはゆらぎがあり、オーナー・編集者による修正が前提の設計です。つまり「誤ったラベルに誰が気づき、誰が直すか」を決めないまま全社展開すると、誤分類が放置されます。対象範囲を部門単位で区切り、その部門にレビュー担当を置く形から始めるのが安全です。シャドーAIの実態調査で見たとおり、ルールを整備しても運用の担い手がいなければ現場は動きません(管理職の46.5%がシャドーAIを利用)。
具体的な活用シーン
Geminiベースのデータ分類が効くのは、「テキストとして中身があり、量が多く、人手で仕分けきれない」ファイル群です。
| 業務・業種 | 対象ファイル | 期待できること | 注意点 |
|---|---|---|---|
| 法務・購買(全業種) | 共有ドライブ上の契約書・見積書PDF | 取引先名や金額を含む文書に機密ラベルを付け、DLPポリシーと保持ルールを一括で効かせる | CSE適用済みの契約書は対象外。日本語文書は試験運用で精度を確認する |
| 人事(全業種) | 人事評価・採用応募書類 | 閲覧範囲を限定すべき文書を洗い出し、共有設定の誤りを検知する起点にする | ラベル付与前に、誰が修正権限を持つかを決めておく |
| 製造・建設 | 設計図面・仕様書(画像を含むPDF) | OCRでテキスト抽出された図面に技術情報ラベルを付ける | 図面が画像のみでテキスト量が乏しい場合、判定材料が不足する |
いずれの場合も、いきなり全社のドライブを対象にするのではなく、部門1つ・ラベル2〜3種から始め、付与結果を目視で確認する進め方を推奨します。
よくある質問
- Geminiベースのデータ分類は追加費用がかかりますか。
-
Google Workspace Updatesの発表では、対象エディション(Enterprise Plus、Google AI Pro for Education、Frontline Plus)に含まれる機能として案内されており、追加アドオンの購入は求められていません。対象外エディションでの提供有無は公表されていません。
- すでに社内にある古いファイルも分類されますか。
-
分類されますが、Geminiベースの方式では「非アクティブファイルのスキャン」を管理者が手動で有効化する必要があります。有効化後、ファイルは1〜2週間に最低1回スキャンされ、アップロード時と変更時にも評価されます。
- AIが間違ったラベルを付けた場合はどうなりますか。
-
ファイルのオーナーまたは編集者(ラベル適用権限を持つユーザー)が値を修正できます。人が修正した後は、AI分類がそのファイルのラベル値を変更することはありません。
- Driveのファイル内容がGoogleのAIの学習に使われませんか。
-
Google Workspace Helpは、社内Driveの内容と関連するプロンプトは認可されたWorkspace環境内に分離され、Googleのモデルの学習には使われないと明記しています。
まとめ
2026年8月28日に始まったGoogle DriveのGeminiベースのデータ分類は、データ分類プロジェクトの最大の障壁だった「学習ファイルの準備」を取り除きました。ロールアウトの完了目標は2026年9月30日です。
一方で、利用にはEnterprise Plus相当のエディションが必要で、クライアント側暗号化ファイルと動画・音声は対象外、判定にはLLM特有のゆらぎがあり、日本語ファイルでの挙動は公式に明記されていません。「入れれば機密情報管理が終わる」機能ではなく、「ラベル設計とレビュー体制を作った組織が、その作業量を減らせる」機能です。
次に取るべきアクションは3つです。第一に自社のWorkspaceエディションを確認すること。第二に機密の区分(2〜7段階)を業務部門と合意すること。第三に部門1つで試験運用し、日本語ファイルでの付与結果を目視で検証することです。
Auto-IDフロンティアは、AI活用の前提となる社内データの整理と権限設計から支援しています。「AIエージェントを入れたいが、社内文書の機密区分が決まっていない」という段階の相談も多くいただきます。自社のデータ分類とAI導入の順序を整理したい方は、AI導入相談フォームからお気軽にご相談ください。
AI導入の進め方全体は「AI導入支援|中小企業の進め方と支援会社の選び方」、発注前に確認する具体的な基準は「AI導入支援会社の選び方|発注前に確認する7つの基準」で解説しています。
出典・参考資料
- Google Workspace Updates: Gemini-based data classification in Google Drive is now available in open beta ()
- Google Workspace Help: Label Google Drive files automatically using AI classification (対象エディション・制限事項・CSE・言語に関する記述の出典)
- Google Workspace Updates: Leverage the power of Gemini models to apply data classification labels in Google Drive – beta applications now open ()
- Google Workspace Help: Google Workspace with Gemini language support
- HelenTech: Google ドライブの Gemini データ分類、オープンベータへ移行。対象組織を拡大 ()